[Review] 박종훈의 AI 논문 스터디 - 3주차 후기
안녕하세요! K-DEVCON 그로스 매니저 박종훈입니다.
AI 논문 스터디 세 번째 시간이 9월 14일(월)에 있었습니다.
(2주차 후기 보러가기)
지난 두 번은 CNN 이야기였습니다. AlexNet은 이미지를 공간으로 보고 특징을 뽑았고, ResNet은 그 공간 위에 층을 깊게 쌓는 방법을 찾았습니다. 이번 4장에서는 축이 바뀝니다. 문장, 음성처럼 순서가 있는 데이터를 다루는 RNN 이야기입니다.
"어려웠지만 재밌었다"는 반응이 많았습니다. 수식은 낯설지만 그럼에도 열심히 따라가 보았습니다.
---
1. RNN이란
RNN(Recurrent Neural Network, 순환 신경망) 은 순서가 있는 데이터를 다루기 위한 신경망입니다. CNN과 마찬가지로 역전파와 경사하강법으로 학습하지만 데이터를 바라보는 방식이 다릅니다. 스터디에서도 책에 따로 나오지 않는 MLP까지 묶어서 셋을 비교해봤습니다.
| 구조 | 잘 다루는 데이터 | 예시 |
| ------- | -------------------------------------------------------------- | ----------------------------------- |
| MLP | 구조가 없는 데이터 — 숫자 여러 개를 한꺼번에 섞어 답 하나를 냄 | 나이·연봉·근속연수 → 대출 승인 여부 |
| CNN | 공간 구조 — 가까이 있는 것끼리 관련이 깊음 | 이미지 분류, 객체 탐지 |
| RNN | 시간 구조 — 앞에 무엇이 왔는지가 중요함 | 텍스트, 음성, 주가·센서 같은 시계열 |
MLP는 낯선 이름 같지만 사실 이미 봤습니다. AlexNet 뒷부분의 fully-connected 층이 바로 MLP입니다.
가장 큰 차이는 입력의 길이입니다. MLP와 CNN은 정해진 크기의 입력을 받아 정해진 크기의 출력을 냅니다. 반면 RNN은 한 번에 하나씩, 현재 입력과 지금까지 읽은 내용의 요약을 함께 받아 요약을 갱신합니다. 그래서 길이가 제각각인 문장도 같은 모델 하나로 처리할 수 있습니다.
왜 앞의 내용을 기억해야 할까
아래 글의 빈칸을 채워보겠습니다.
아침에 급하게 나오느라 지갑을 식탁 위에 두고 나왔다. 버스를 타고 회사에 도착해서 커피를 사려고 주머니를 뒤졌는데, \_\_\_이 없었다.
답은 지갑입니다. 빈칸 가까이에 있는 단어는 "버스", "회사", "커피", "주머니"인데, 이 중 무엇을 넣어도 말이 되지 않습니다. 답을 정하는 단서는 한 문장 앞, 글의 거의 첫머리에 있는 "지갑을 식탁 위에 두고"입니다. 바로 앞 단어만 봐서는 풀 수 없고, 앞에서 읽은 내용을 기억한 채로 끝까지 가져가야 합니다.
RNN 이전에 쓰던 n-gram 언어 모델이 정확히 여기서 막힙니다. n-gram은 "다음 단어는 직전 몇 개 단어만 보면 정해진다"는 마르코프 가정 위에 서 있습니다. 3-gram이라면 직전 두 단어만 보고, 그보다 앞은 아예 없는 것처럼 잘라냅니다. 게다가 본질적으로 거대한 빈도표라서 "사과"와 "배"는 서로 아무 관계 없는 기호일 뿐입니다. 학습 데이터에 "사과를 먹었다"는 있는데 "배를 먹었다"가 한 번도 없었다면 그 확률은 0이 됩니다.
RNN은 지금까지 읽은 내용을 계속 누적해 넘기기 때문에 이론상 문장 맨 앞까지 닿을 수 있습니다. 물론 "이론상"이라는 단서가 붙습니다. 그 단서가 이번 장 전체의 이야기입니다.
2. RNN은 어떻게 흘러왔나
RNN은 하루아침에 나온 구조가 아닙니다. 주요 흐름을 정리해보면 다음과 같습니다.
LSTM 이전 — 순환 구조를 찾아가던 시기
- Hopfield Network (1982) — 순환 연결을 가진 초기 신경망입니다. 시퀀스 처리보다는 연상 기억용이었지만 순환 구조의 출발점으로 꼽힙니다.
- Jordan Network (1986) — 자기 출력을 다음 시점의 입력으로 되돌립니다. 초반에 틀린 출력을 내면 그 오류가 그대로 다음 입력이 되어 누적된다는 약점이 있었습니다.
- Elman Network (1990) — 출력 대신 히든 스테이트를 다음 시점으로 넘깁니다. 오늘날 "기본(vanilla) RNN"이라고 부르는 형태가 이것입니다.
- BPTT — 모델이라기보다 학습 방법입니다. 시간 축으로 펼친 RNN에 역전파를 적용하는 방법이 이 시기에 정리되면서 RNN을 실제로 학습시킬 수 있게 됐습니다.
그런데 이 시기 모델들은 공통적으로 긴 시퀀스를 학습하지 못했습니다. 1990년대 초중반 연구들이 그 원인으로 기울기 소실을 짚었고, 이를 풀기 위해 나온 것이 1997년 Hochreiter와 Schmidhuber의 LSTM입니다.
LSTM 이후 — 번역에서 트랜스포머까지
- Seq2Seq (2014) — LSTM 두 개를 이어 붙여 기계번역을 통째로 해냈습니다. 하나(인코더)가 문장을 읽어 고정된 크기의 벡터로 요약하고, 다른 하나(디코더)가 그 벡터로 번역문을 씁니다. 이 논문 이후 기계번역을 비롯한 여러 자연어 처리 분야에서 LSTM 기반 모델이 널리 쓰였습니다. 이 스터디 교재의 이름이 된 일리야 서츠케버가 1저자입니다.
- Attention (2015) — 긴 문장을 벡터 하나에 욱여넣다 보니 정보가 손실됐습니다. 디코더가 번역하면서 입력 문장의 필요한 부분을 직접 돌아보게 만든 것이 어텐션입니다.
- Transformer (2017) — 순환 구조를 아예 버리고 어텐션만으로 시퀀스를 처리합니다. 엄밀히는 RNN이 아니지만 사실상 RNN 계열을 대체했습니다.
3. RNN의 구조
히든 스테이트
RNN은 앞의 내용을 기억하는 문제를 히든 스테이트(hidden state) 로 해결합니다.
히든 스테이트는 우리말로 은닉 상태라고 하고, 신경망의 은닉층(hidden layer) 이 내놓는 값입니다. 신경망은 크게 세 부분으로 나눠볼 수 있습니다.
- 입력층 — 우리가 밀어 넣는 값입니다. 이미지 픽셀, 단어 벡터, 센서 값 같은 것들이죠.
- 출력층 — 우리가 정답을 알려주는 값입니다. "이 사진은 고양이", "다음 글자는 a" 같은 것들입니다.
- 은닉층 — 그 사이입니다. 우리가 값을 정해주지 않고, 학습하면서 네트워크가 알아서 채웁니다. 밖에서 직접 들여다보거나 지정하지 않는다는 뜻에서 "숨겨진(hidden)"이라는 이름이 붙었습니다.
RNN에서는 이 은닉층의 값이 지금까지 읽은 내용의 요약 역할을 합니다. 128차원 히든 스테이트라면 숫자 128개짜리 벡터 하나에 앞의 글이 압축되어 담기는 셈입니다. 어떤 숫자가 어떤 의미인지는 사람이 정하지 않고 학습으로 정해집니다.
매 시점마다 이번 입력과 직전 히든 스테이트를 섞어 새 히든 스테이트를 만들고, 그걸 다음 시점으로 넘깁니다.
h(t) = tanh( W_h · h(t-1) + W_x · x(t) + b )
순환 구조를 펼쳐 보면
책의 그림에서는 이 모듈이 옆으로 쭉 펼쳐져 있어서 층이 여러 개인 것처럼 보입니다. 그런데 실제로는 같은 모듈 하나를 시점마다 반복해서 쓰는 것입니다. 그래서 이름이 순환(recurrent) 신경망입니다.
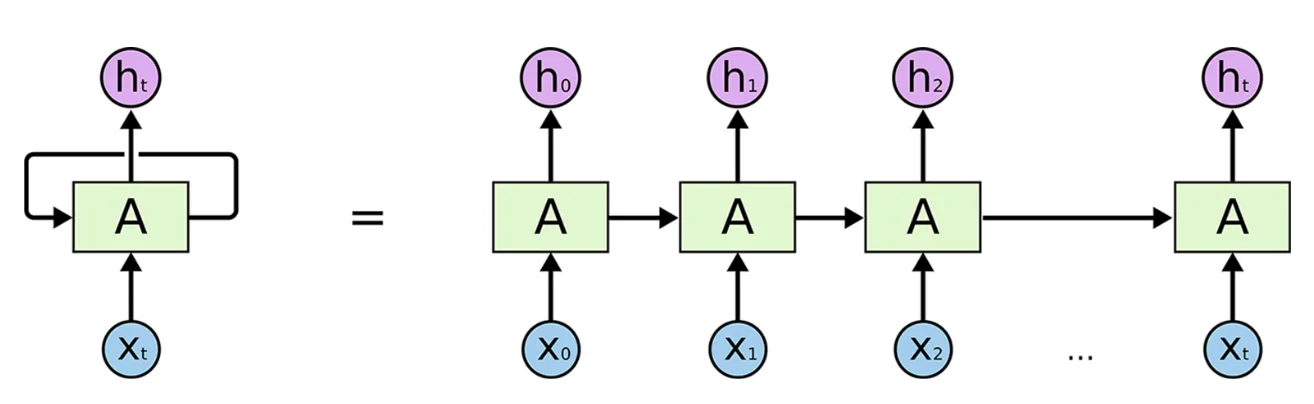 출처: Christopher Olah, Understanding LSTM Networks (2015)
왼쪽과 오른쪽은 같은 그림입니다. 왼쪽은 모듈
A가 자기 출력을 다시 자기에게 넘기는 순환 구조를 그대로 그린 것이고, 오른쪽은 이를 시간 축으로 펼친(unroll) 것입니다. 오른쪽에 A가 여러 개 보이지만 모두 같은 가중치를 쓰는 하나의 모듈이고, A 사이를 잇는 가로 화살표가 매 시점 넘겨주는 히든 스테이트입니다.
RNN의 동작 방식 — 한 스텝씩
RNN은 시퀀스를 통째로 받지 않고 잘라서 하나씩 넣습니다. 그 하나하나를 스텝(step), 또는 시점(time step)이라고 부릅니다. 앞의 수식에 나온 t가 스텝 번호입니다.
"나는 밥을 먹었다"를 단어 단위로 넣는다면 이렇게 흘러갑니다.
시작    h0 = [0, 0, …, 0]                  (아직 읽은 게 없으니 0으로 시작)
스텝 1  x1 = "나는"   → h1 = f(h0, x1)
스텝 2  x2 = "밥을"   → h2 = f(h1, x2)     ← "나는"의 요약이 h1에 담겨 들어옴
스텝 3  x3 = "먹었다" → h3 = f(h2, x3)     ← "나는 밥을"의 요약이 h2에 담겨 들어옴
몇 가지를 짚어볼 수 있습니다.
- 매 스텝 같은
f를 씁니다. 스텝이 바뀌어도 f 안의 가중치는 바뀌지 않습니다. 이 부분은 바로 이어서 자세히 봅니다.
- 스텝 수는 입력 길이에 따라 달라집니다. 세 단어면 세 스텝, 백 단어면 백 스텝입니다. 모델이 바뀌는 게 아니라 반복 횟수만 바뀝니다.
- 마지막
h3에는 문장 전체의 요약이 들어 있습니다. 다만 앞 스텝의 정보는 여러 번 섞이면서 조금씩 흐려집니다. 이게 뒤에서 볼 기울기 소실, 그리고 LSTM으로 이어지는 이야기입니다.
- 출력을 언제 쓸지는 문제에 따라 다릅니다. 매 스텝마다 다음 단어를 예측하게 할 수도 있고, 문장 분류처럼 마지막 스텝의
h만 쓸 수도 있습니다.
같은 가중치를 사용한다는 것
펼친 그림에서 A가 여러 개 보이지만 가중치는 W_h, W_x, b 한 벌뿐이고, 모든 스텝이 이 한 벌을 똑같이 사용합니다. 문장이 5단어든 500단어든 파라미터 수는 똑같고, 학습할 때 본 적 없는 길이의 문장도 처리할 수 있습니다.
여기서 가중치 "한 벌"을 숫자 몇 개로 생각하면 안 됩니다. 수식에서는 W 한 글자로 적혀 있지만 실제로는 숫자가 가득 찬 배열(행렬) 입니다. "같은 가중치를 사용한다"는 말은 이 배열들을 스텝마다 새로 만들지 않고 그대로 다시 쓴다는 뜻입니다.
다만 "같은 가중치를 사용한다"는 것은 스텝을 따라 가로로 흐르는 방향의 이야기입니다. RNN은 이와 별개로 세로로 쌓을 수도 있습니다. 첫 번째 RNN이 스텝마다 내놓는 히든 스테이트를 두 번째 RNN의 입력으로 넣는 식이고, 이때는 일반 신경망처럼 층마다 가중치가 따로 있습니다. 이번 시간에는 크게 다루지 않았고, 다음 시간에 LSTM을 여러 층 쌓아 번역을 해낸 Seq2Seq을 읽으면서 본격적으로 나올 예정입니다.
4. RNN에도 기울기 소실이 찾아온다
지난 시간 ResNet 후기에서 층이 깊어지면 미분값이 곱해지면서 앞쪽 층까지 신호가 가지 못한다는 이야기를 했습니다. RNN은 층이 한두 개인데도 같은 문제를 겪습니다.
RNN을 학습할 때는 시간 축으로 펼친 상태에서 역전파를 합니다. 이걸 BPTT(Backpropagation Through Time) 라고 부릅니다. 펼쳐놓고 보면 문장 길이만큼 층이 쌓인 깊은 네트워크와 같습니다. 100단어짜리 문장이면 첫 단어까지 기울기가 가려면 W_h와 tanh의 미분값이 100번 곱해집니다. tanh의 기울기는 최대 1이라 곱할수록 작아지고, 결국 문장 앞쪽 내용은 학습 신호가 닿지 않습니다. 긴 문장에서 앞의 맥락을 잊어버리는 이유입니다.
5. LSTM — 기억을 위한 별도 통로
이 문제를 풀려고 나온 것이 LSTM(Long Short-Term Memory) 입니다. 스터디에서 가장 많이 이야기한 부분이기도 합니다.
셀 스테이트와 게이트
LSTM은 히든 스테이트 옆에 셀 스테이트(cell state) 라는 통로를 하나 더 둡니다. 보통 셀 스테이트를 장기 기억, 히든 스테이트를 단기 기억에 빗댑니다. 그리고 이 통로를 드나드는 정보를 세 개의 게이트가 조절합니다.
| 게이트 | 하는 일 |
| --------------- | ---------------------------------------------- |
| 망각 게이트 f | 이전 기억 중 얼마나 남길지 |
| 입력 게이트 i | 새 정보를 얼마나 기억에 더할지 |
| 출력 게이트 o | 기억 중 얼마나 꺼내서 히든 스테이트로 내보낼지 |
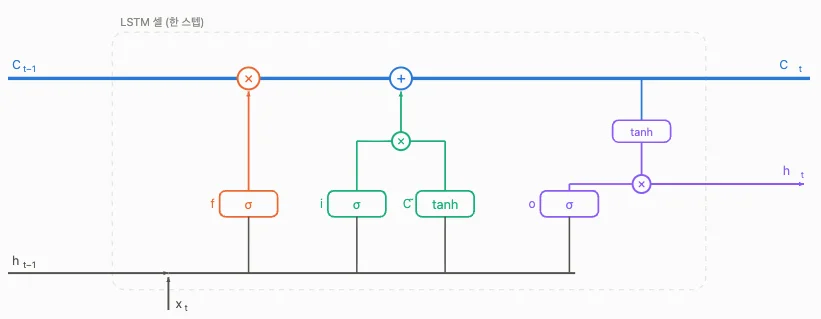 위쪽을 가로지르는 굵은 선이 셀 스테이트, 아래쪽 선이 히든 스테이트입니다. 주황색이 망각 게이트, 초록색이 입력 게이트와 후보 값, 보라색이 출력 게이트입니다.
시그모이드와 tanh가 다시 나온 이유
CNN에서는 ReLU를 썼는데, LSTM에서는 시그모이드와 tanh가 다시 등장합니다. 두 함수는 여기서 이런 역할을 합니다.
- 시그모이드는 값을 0~1 사이로 만듭니다. 그래서 "얼마나 통과시킬지"를 나타내는 게이트로 씁니다. 0이면 막고 1이면 전부 통과시킵니다.
- tanh는 값을 -1~1 사이로 만듭니다. 기억에 더할 후보 값을 만들고, 셀 스테이트를 꺼낼 때 한 번 더 씌웁니다. 값이 너무 커지거나 작아지지 않게 붙잡아두는 역할입니다.
기울기가 살아남는 이유 — 덧셈으로 이어지는 셀 스테이트
셀 스테이트는 매 스텝 이렇게 갱신됩니다.
c(t) = f ⊙ c(t-1) + i ⊙ g (g: 새로 기억할 후보 값)
이전 기억에 망각 게이트 값을 곱해 남길 만큼 남기고 새로 기억할 값을 더합니다. 기본 RNN은 매 스텝 가중치 행렬을 곱하고 tanh를 씌워 히든 스테이트를 새로 만들지만, 셀 스테이트는 이전 값 위에 더해 가는 방식으로 이어집니다.
덧셈은 미분해도 기울기가 그대로 전달됩니다. 그래서 망각 게이트가 열려 있는 한, 기울기가 여러 스텝을 거슬러 올라가도 크게 줄어들지 않습니다. 지난 시간에 본 ResNet의 스킵 커넥션이 층을 건너뛰는 지름길이었다면, 셀 스테이트는 시간을 건너뛰는 지름길인 셈입니다.
히든 크기와 가중치 수
LSTM의 히든 스테이트는 숫자 하나, 즉 1차원이어도 동작은 합니다. 하지만 숫자 하나에 앞의 내용을 요약해 담기에는 턱없이 부족하기 때문에 실제로는 수십~수백 칸짜리 벡터를 씁니다. 이 칸 수를 히든 크기라고 부르고, 글을 얼마나 길게 읽든 히든 스테이트의 크기는 그대로입니다.
가중치 행렬의 크기는 이 히든 크기(H)와 입력 크기(D, 매 스텝 들어오는 벡터의 길이)로 정해집니다. LSTM의 게이트 세 개와 후보 값은 모두 이전 히든 스테이트(H)와 이번 입력(D)을 이어붙인 H + D차원 벡터를 받아 H차원을 내놓습니다.
게이트(또는 후보 값) 하나 = H × (H + D)  +  H
                           가중치 행렬     편향

LSTM 층 하나 = 4 × [ H × (H + D) + H ]
H × (H + D) 행렬은 사실 앞에서 본 W_x와 W_h를 옆으로 붙여놓은 것입니다. 입력을 받는 H × D 부분이 W_x, 이전 히든 스테이트를 받는 H × H 부분이 W_h입니다. W_h · h(t-1)처럼 곱셈 한 번으로 적혀 있어도 실제로는 이 행렬 전체가 행렬곱에 참여합니다. 그리고 이 가중치들은 앞에서 본 것처럼 모든 스텝이 같은 것을 사용하니, 문장 길이와 상관없이 이 숫자 그대로입니다.
식에 H가 두 번 곱해지기 때문에 히든 크기를 키우면 담을 수 있는 정보는 늘지만 파라미터는 대략 제곱으로 늘어납니다.
6. 직접 돌려본 LSTM — 글자 생성 예제
이번 파트는 책에 있는 내용이 아니라, 스터디에서 LSTM을 더 잘 이해해보려고 따로 준비한 예제입니다. 코드는 여기에 올려두었습니다.
Python for Microscopists 167번 영상의 코드를 최신 라이브러리에서 돌아가도록 손본 것입니다. 키플링의 『정글북』 원문으로 LSTM을 학습시켜 앞의 60글자를 보고 다음 한 글자를 예측하게 만듭니다. 원문을 60글자씩 잘라 입력으로, 바로 다음 한 글자를 정답으로 삼으면 약 2만 7천 개의 학습 샘플이 만들어집니다.
이 예제를 따라가며 앞에서 정리한 개념들이 실제 코드에서 어떤 숫자가 되는지 살펴보았습니다.
모델에게 글자를 학습하게 하기
모델에게 어떻게 글자를 학습하게 할 수 있을까요? 가장 쉽게 떠올릴 수 있는 방법은 글자마다 번호를 붙여 그 번호를 그대로 넣는 것입니다. 'a'는 14, 'i'는 22, 'z'는 39 하는 식이죠(번호는 설명을 위해 붙인 값입니다). 그런데 이러면 문제가 생깁니다. 신경망은 곱하고 더하는 게 전부라서 숫자를 크기로 받아들입니다. 'z'가 'a'보다 훨씬 "크다"거나, 'i'가 둘 사이 어딘가에 있다는, 실제로는 없는 순서 관계를 학습해버립니다.
그래서 쓰는 방법이 원-핫 인코딩입니다. 글자 종류 수(예제에서는 45)만큼 칸이 있는 벡터를 만들고, 해당 글자 자리 한 칸(one)만 켭니다(hot).
'i' → [0, 0, …, 0, 1, 0, …, 0]
                   ↑ 22번 칸만 1
      ←──────── 45칸 ────────→
이렇게 하면 모든 글자가 서로 같은 거리에 놓여 크기 관계가 사라집니다. 다만 한계도 분명합니다. 단어 단위로 가서 어휘가 1만 개가 되면 길이 1만짜리 벡터가 필요해 너무 커집니다.
원-핫 인코딩에서 임베딩으로
이를 해결하기 위해서 임베딩을 사용합니다. 단어마다 작은 크기의 실수 벡터를 하나씩 배정하고, 그 값을 학습으로 정합니다.
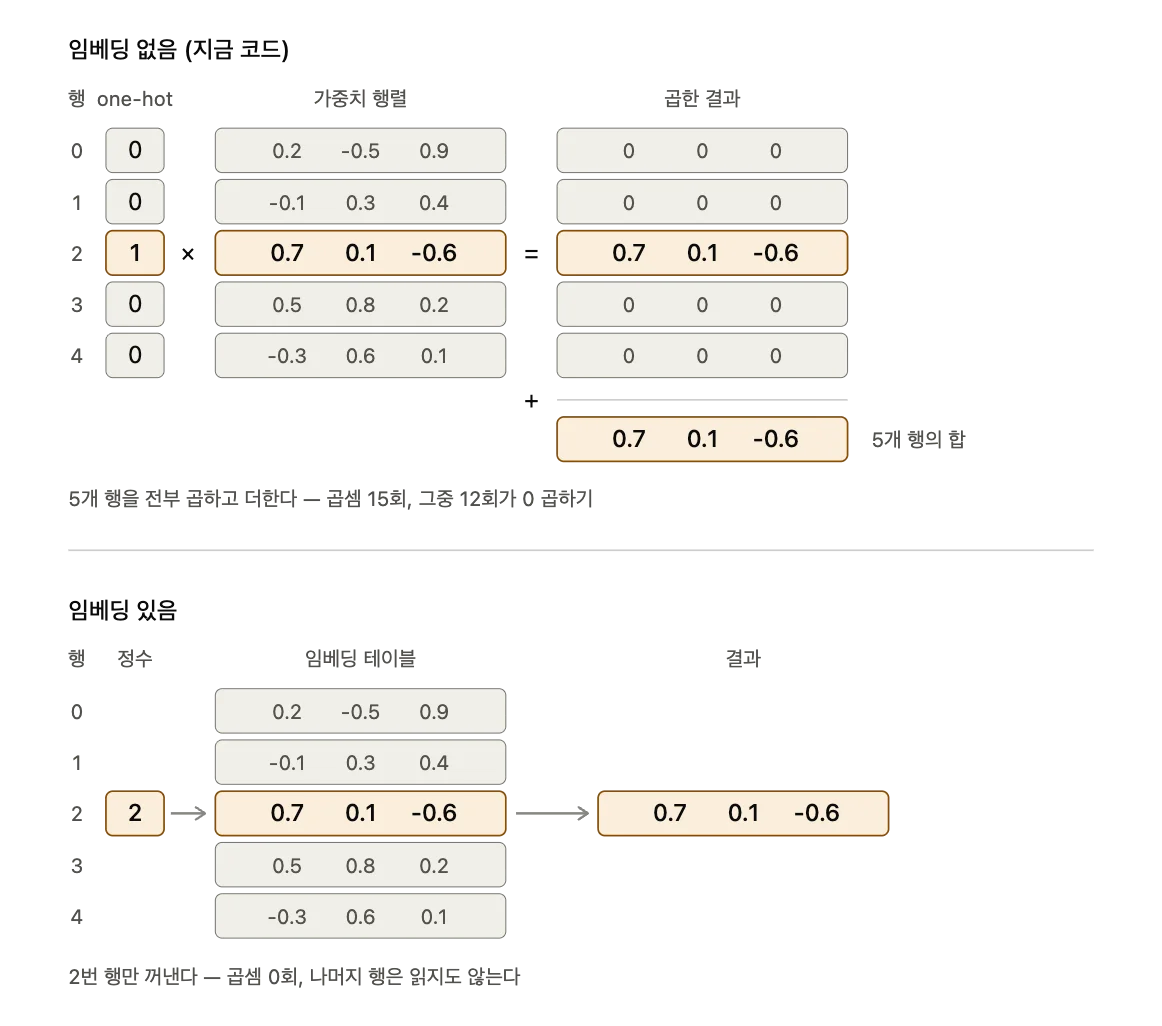 원-핫 인코딩에 가중치 행렬을 곱하는 것과 임베딩은 수학적으로 같은 계산입니다. 원-핫 벡터는 한 칸만 1이라 행렬을 곱해도 결국 그 행만 남기 때문입니다(위). 임베딩은 굳이 곱셈을 하지 않고 번호로 그 행을 바로 꺼냅니다(아래). 결과는 같은데 곱셈이 사라지고, 원-핫 벡터 대신 정수 하나만 들고 다니면 되니 메모리도 크게 줄어듭니다.
이 예제는 원-핫을 쓰지만, 만약 45글자짜리 사전에 16차원 임베딩을 쓴다면 표는
45 × 16 크기가 됩니다. 여기에 정글북 주인공 이름 "mowgli"가 들어오면 이렇게 됩니다.
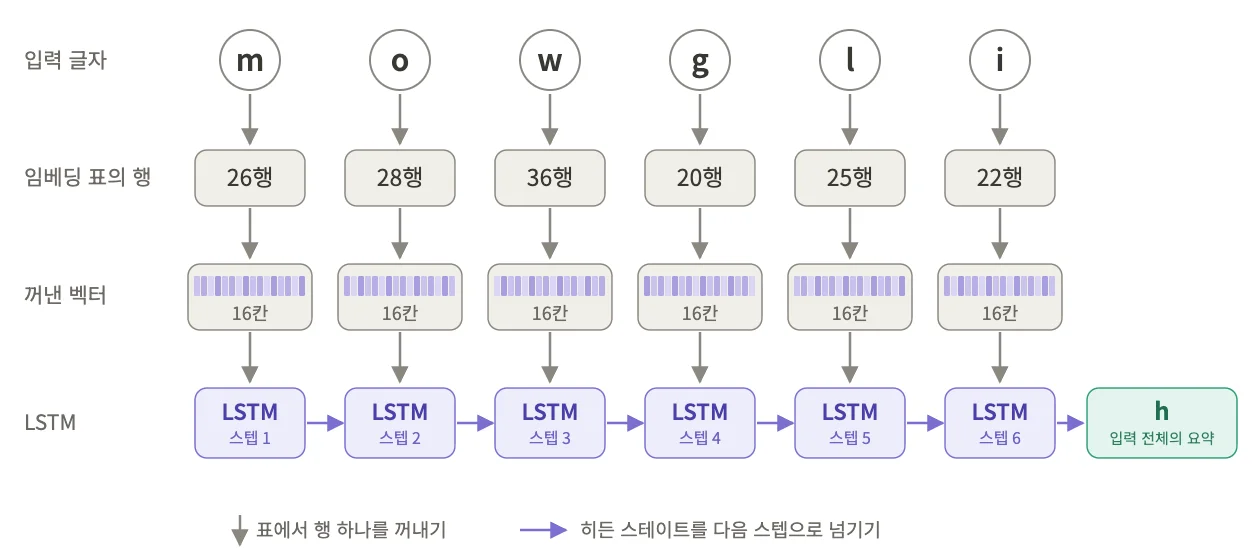 임베딩은 글자(단어) 하나마다 표에서 행 하나를 꺼내 줍니다(세로 화살표). 그 후 LSTM이 벡터를 차례로 읽으며 히든 스테이트를 갱신해 다음 스텝으로 넘기고(가로 화살표), 마지막 스텝의 히든 스테이트가 입력 전체를 요약한 벡터 하나가 됩니다.
RNN의 임베딩과 LLM의 임베딩은 다른가
"RNN에서 말하는 임베딩과 LLM에서 말하는 임베딩은 다르다"는 이야기도 한동안 이어졌습니다. 결론부터 말하면 표 자체는 같은 구조입니다. 트랜스포머 기반 LLM도 입력단에서는 똑같이 고정된 어휘에 대한 룩업 테이블을 씁니다.
표의 값은 학습하면서 바뀌기 때문에, RNN에서도 비슷하게 쓰이는 단어일수록 벡터 공간에서 가까운 곳에 놓입니다. 다만 데이터가 적거나 이번 예제처럼 글자 45개짜리 사전이라면 그런 구조가 뚜렷하게 드러나지는 않고, 대규모로 학습한 LLM에서 더 잘 보입니다.
그런데 표에서 꺼낸 벡터는 문맥을 모릅니다. 같은 글자나 단어라면 어떤 문장에 있든 표에서 똑같은 벡터를 꺼냅니다.
문맥이 반영되는 건 그다음 단계입니다. RNN은 앞에서 읽은 내용이 담긴 히든 스테이트에 이 벡터를 섞으면서, 트랜스포머는 어텐션으로 문장 속 다른 단어들을 직접 살펴보면서 문맥을 입힙니다.
그러니까 RNN과 LLM의 차이는 임베딩 표에 있는 게 아니라, 표에서 꺼낸 벡터에 문맥을 어떻게 입히느냐에 있습니다. 흔히 벡터 DB에 넣는 "임베딩"은 이 표가 아니라, 모델 전체를 통과해 문맥까지 반영된 출력 벡터입니다.
이 예제에 임베딩을 쓰면
이 예제는 입력을 원-핫으로 넣습니다. 샘플 약 2만 7천 개 × 60글자 × 45칸이라, 한 칸에 1바이트씩만 잡아도 입력 배열이 약 74MB입니다. 그런데 45칸 중 44칸이 0이니 대부분이 빈 공간입니다.
임베딩을 쓰면 글자마다 45칸 벡터 대신 글자 번호 하나만 들고 있으면 됩니다. 같은 데이터가 (샘플 수, 60) 크기의 정수 배열이 되어 약 7MB 수준으로 줄어듭니다.
LSTM(128) 안에서는 — 512를 네 토막으로
예제 코드는 LSTM을 LSTM(128), 즉 히든 크기 128로 만듭니다. 글자 하나가 LSTM에 들어오면 이전 히든 스테이트와 함께 가중치 행렬과 곱해져 512개의 값이 나옵니다.
512는 128 × 4입니다. 5절에서 본 것처럼 LSTM에는 망각·입력·출력 게이트와 후보 값, 이렇게 네 가지 계산이 있고, 히든 크기가 128이니 각각 128칸짜리 결과가 필요합니다. 그래서 네 개를 따로 계산하지 않고 한 번에 512개를 만든 뒤 128개씩 네 토막으로 잘라 각자에게 나눠 줍니다.
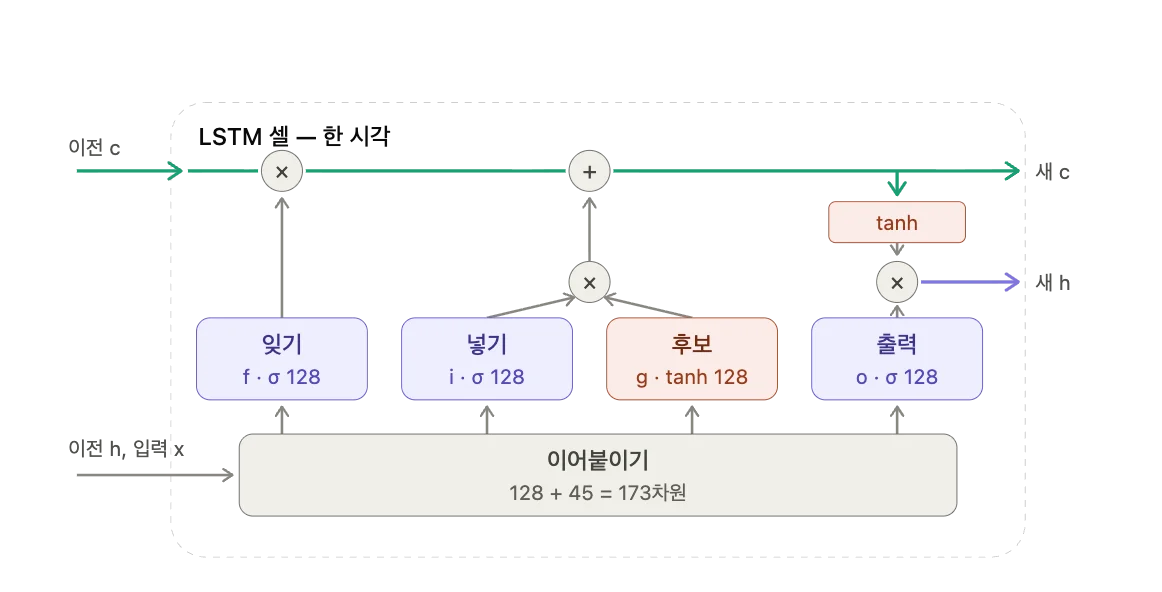 그림의 아래쪽 네 블록(잊기·넣기·후보·출력)이 바로 그 네 토막입니다. 블록마다 128칸씩, 합치면 512칸입니다. 들어가는 쪽은 글자 벡터(45)와 이전 히든 스테이트(128)를 이어붙인 173칸이고, 나오는 쪽은 128 × 4 = 512칸입니다.
출력과 생성 — 시드와 temperature
책의 그림에는 출력층이 없어서 결과가 어떻게 나오는지 궁금했다는 이야기도 나왔습니다. LSTM의 히든 스테이트를 Dense 층에 통과시켜 어휘 크기만큼의 점수를 만들고, softmax로 확률로 바꿉니다. 그중 하나를 골라 다음 글자로 쓰고, 그 글자를 다시 입력으로 넣어 계속 이어갑니다.
그럼 맨 처음은 어떻게 시작할까요. 아무것도 없는 상태에서 시작하는 게 아니라, 시드가 되는 글을 먼저 넣고 그다음부터 이어서 생성합니다. 요즘 LLM에서는 사용자가 입력하는 프롬프트가 바로 이 시드 역할을 합니다. 여기서 "같은 입력을 넣으면 항상 같은 답이 나오나"로 대화가 이어졌습니다.
답은 "꼭 그렇지는 않다"입니다. softmax는 다음 글자가 무엇일지에 대한 확률 분포를 줄 뿐이고, 실제로는 그 분포에서 추첨하듯 하나를 뽑습니다. 그래서 확률이 가장 높은 글자가 매번 나오는 게 아니라, 같은 입력이어도 결과가 달라질 수 있습니다.
이 추첨의 성격을 조절하는 값이 temperature입니다. softmax에 넣기 전에 점수를 temperature로 나누는데, 값을 높이면 분포가 평평해져 확률 낮은 글자도 자주 뽑히고 결과가 다양하지만 엉뚱해집니다. 반대로 낮추면 확률 높은 글자로 쏠려 안정적이지만 반복적인 글이 나오고, 0에 가까워지면 거의 항상 1등만 고르게 됩니다.
7. RNN의 한계, 그리고 트랜스포머
RNN과 LSTM의 한계를 이야기하다 보니 자연스럽게 다음 장인 트랜스포머로 넘어갔습니다.
LSTM이 여전히 풀지 못한 것
LSTM까지의 방식은 결국 앞에서부터 읽으며 고정된 크기의 기억에 요약해 넘기는 구조입니다. 여기서 두 가지 한계가 생깁니다.
- 먼저 들어온 정보가 먼저 흐려집니다. 셀 스테이트가 있어도 정보는 한 줄로 전달되고, 기억의 크기도 정해져 있습니다. 첫 문장에 중요한 정보가 있고 한참 뒤에야 다시 언급되는 글이라면 맞히기 어렵습니다.
- 병렬로 계산할 수 없습니다. 한 분은 이걸 가장 치명적인 단점으로 꼽으셨습니다. t번째를 계산하려면 t-1번째 결과가 있어야 하니 순서대로만 계산할 수 있고, GPU가 잘하는 병렬 연산을 살리지 못합니다.
트랜스포머는 다 연결해버린다
2절에서 본 흐름에서 Seq2Seq과 Attention 사이가 분기점입니다. Attention부터는 요약본 하나에 기대지 않고 입력 전체를 필요할 때마다 다시 봅니다. 그리고 트랜스포머는 순환 구조를 아예 버리고 이 방식만으로 시퀀스를 처리합니다.
트랜스포머에서는 모든 단어가 다른 모든 단어를 직접 봅니다. 단어마다 Query, Key, Value 세 벡터를 만들고, 한 단어의 Query를 다른 모든 단어의 Key와 비교해 얼마나 주목할지 정합니다. 길이가 N이면 N×N번 비교하니 연산량은 O(N²) 으로 늘지만, 거리가 멀어도 한 번에 연결되고 한꺼번에 병렬로 계산할 수 있습니다. LSTM의 두 한계를 정면으로 푼 셈입니다. 생성할 때 이전 단어들의 Key와 Value를 매번 다시 계산하지 않고 저장해두는 것이 KV 캐시이고, 긴 대화에서 메모리를 많이 쓰는 이유이기도 합니다.
그래서 지금 자연어 처리의 주류는 트랜스포머이고, LSTM이나 GRU 같은 고전적인 RNN은 대부분의 자리를 내줬습니다.
그럼 이 장은 왜 읽었을까
"지금 AI를 처음 공부한다면 RNN과 LSTM은 건너뛰고 바로 트랜스포머로 가도 되지 않나"라는 이야기도 나왔습니다. 대학 강의에서도 깊게 다루지 않았다는 경험담도 있었고요.
그래도 이 장이 들어간 이유에 대해 두 가지 의견이 나왔습니다. 하나는 2~3장 내내 "정보를 어떻게 잃지 않고 넘길까"를 고민해왔는데, 5장에서 어텐션이 "처음부터 다 보면 되잖아"로 그 흐름을 뒤집는 장면을 보여주려는 것 같다는 의견입니다. 다른 하나는 다음 장의 seq2seq과 인코더-디코더 개념이 이 위에서 나오고, 그 구조가 트랜스포머까지 이어지기 때문이라는 의견입니다.
8. 그 외에 나온 이야기들
지난 시간에 나눴던 증류 이야기가 이번에도 이어졌습니다. 계기는 최근 Anthropic이 공개한 사례였습니다. 일부 AI 기업이 우회 계정으로 Claude의 응답과 추론 과정을 대량으로 수집해 무단 증류에 썼다는 내용입니다.
긴 컨텍스트 이야기도 나왔습니다. 2023년에 나온 Lost in the Middle 논문(Liu et al.)에 따르면, 정답 정보가 긴 컨텍스트의 중간에 있으면 앞이나 끝에 있을 때보다 정답률이 떨어집니다. 컨텍스트 창이 커진 지금도 자주 인용되는 내용입니다.
가장 뜨거웠던 곁가지는 초파리 뇌 시뮬레이션이었습니다. 초파리의 뇌 연결 지도(FlyWire 커넥톰, 뉴런 약 14만 개)를 그대로 옮긴 모델이 실제 초파리처럼 반응한다는 소식이었는데, 동물실험을 대신할 수 있을지, 반대로 악용되면 어떨지까지 이야기가 번졌습니다.
9. 다음 시간에 다뤄볼 것
다음 시간에는 순환 신경망을 음성 인식에 적용한 Deep Speech 2를 볼 예정입니다.
그리고 Seq2Seq도 미리 읽어오기로 했습니다. 다다음 시간에 5장에서 트랜스포머와 함께 다룰 논문이지만, LSTM 두 개로 기계번역을 해낸 연구라 LSTM을 다룬 이번 흐름에서 먼저 읽어두는 게 좋겠다고 봤습니다. 하나가 문장을 읽어 요약하고 다른 하나가 그 요약으로 번역문을 쓰는 구조로, 이번에 미뤄둔 LSTM을 여러 층 쌓는 이야기도 여기서 나옵니다.
마무리
 이번 시간에는 각자 이해한 내용을 꺼내놓고 서로 맞춰나가는 시간이 많았습니다. 처음에는 서로 생각이 달랐던 부분도 있었지만, 이야기를 주고받고 자료를 함께 보면서 조금씩 이해를 맞춰갔습니다. 혼자 읽고 넘어갔다면 금방 흐려졌을 내용도 이렇게 같이 정리한 덕분에 훨씬 오래 남을 것 같습니다.
참여해주신 분들 모두 고생 많으셨습니다. 다음 시간에 뵙겠습니다.