가성비 커뮤니티 스팸 필터링 구현해보기 (Jev, GPT Luna)
들어가며
사이트를 운영하다 보면 스팸은 꼭 찾아온다. K-DEVCON 커뮤니티는 규모가 크지 않은데도 성인 관련 스팸이 여러 차례 올라왔다. 이런 곳까지 오시다니...
현재 사이트에 새 글이나 댓글이 올라오면 나한테 실시간으로 알림이 온다. 그래서 스팸이 올라와도 대부분은 금방 보고 지울 수 있었다. 하지만 나도 사람인지라 모든 알림을 그때그때 확인할 수는 없다. 회사에서 일하는 중이거나 자고 있을 때 올라온 스팸은 내가 알림을 확인할 때까지 그대로 남아 있었다.
그래서 사람이 보기 전에 먼저 걸러 주는 장치를 두기로 했다. 글이 올라오면 모델에 스팸인지 물어보고 확신도가 높으면 자동으로 가리는(블라인드) 기능을 만들었다.
처음에는 gpt-5.6-luna로
스팸 판정은 어려운 추론이 아니다. 글 하나를 보고 "광고냐 아니냐"만 답하면 된다. 대신 글이 올라올 때마다 호출되니 단가가 중요하다. 그래서 가격이 싸면서 어느 정도 성능이 나오는 모델 위주로 봤다.
처음 고려한 건 Meta의 muse-spark-1.3-contributor였다. 코드리뷰 액션에 이미 쓰고 있었고 단가도 싸다. 그런데 contributor 티어는 보낸 프롬프트가 모델 학습에 쓰인다. 코드리뷰는 우리 코드를 보내지만, 스팸 판정은 회원이 쓴 글을 보낸다. 이용약관 문제가 생길 수 있어서 OpenAI의 gpt-5.6-luna를 골랐다. GPT-5.6 라인업에서 가장 싸고 빠른 등급이다.
구현은 평범한 채팅 모델 호출이다. /chat/completions에 시스템 프롬프트와 글을 보내고 JSON으로 답을 받는다.
너는 한국 개발자 커뮤니티의 게시글 스팸 판별기다. 주어진 글이 스팸인지 판정한다.

스팸인 것:
- 커뮤니티 주제와 무관한 상업적 광고 (대출, 도박, 성인물, 의약품, 코인 리딩방)
- 본문 없이 외부 링크·연락처(카톡 ID, 텔레그램)로 유도만 하는 글
...
스팸이 아닌 것 (개발자 커뮤니티에서는 정상이다):
- 채용 공고, 스터디·사이드프로젝트 모집, 행사·밋업 홍보
- 자기 블로그·깃허브·발표 자료 공유
...
판정이 애매하면 스팸이 아니다.

JSON 으로만 답한다.
{"spam": true|false, "confidence": 0.0~1.0, "reason": "한국어 한 문장"}
프롬프트에서 제일 신경 쓴 건 "스팸이 아닌 것" 쪽이다. 개발자 커뮤니티에서는 채용 공고, 스터디 모집, 자기 블로그 링크 같은 글이 흔한데, 이런 글은 스팸과 통계적 특징이 많이 겹친다. 정상이라고 못박아 두지 않으면 모델이 쉽게 스팸으로 찍는다. "애매하면 스팸이 아니다"라는 문장도 같은 이유로 넣었다.
스팸으로 판정되면
확신도가 임계값(게시글 0.85, 댓글 0.9)을 넘으면 글을 지우지 않고 블라인드 처리한다. 자동 판정에는 오탐이 있을 수밖에 없다. 지운 글은 되돌릴 수 없지만 가린 글은 관리자가 다시 풀 수 있다.
프론트에서는 게시글이 이렇게 보인다.
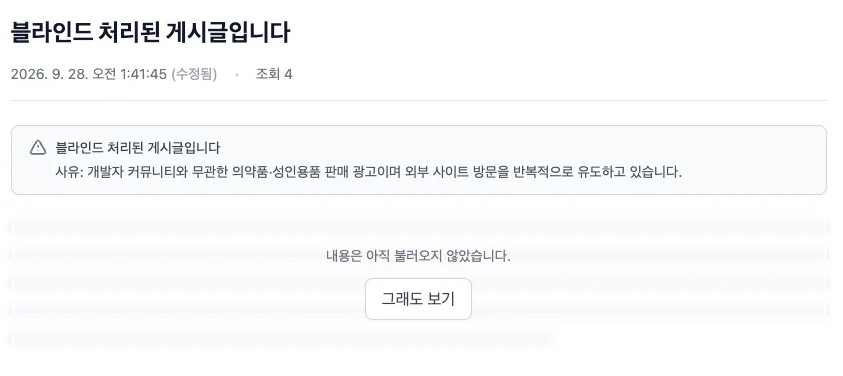
제목은 "블라인드 처리된 게시글입니다"로 바뀌고 모델이 쓴 사유 한 문장이 함께 보인다. 본문은 흐리게 가려 두었다가 "그래도 보기"를 눌러야 불러온다.
댓글도 같은 방식으로 처리했다.
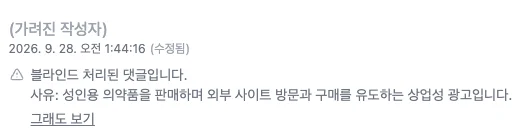
"그래도 보기"는 화면에서만 가려 둔 내용을 펼치는 버튼이 아니다. 목록·상세 API는 가려진 글의 본문을 아예 null로 내려보낸다. 원문은 버튼을 눌렀을 때 GET /api/posts/{id}/blinded-content(댓글은 /api/comments/{id}/blinded-content)로 따로 가져온다. 응답에 원문을 실어 두고 화면에서만 가리면 API를 직접 부르는 쪽에는 스팸 본문이 그대로 나간다. 그러면 가림은 장식에 불과해진다. 사이트맵이나 llms.txt처럼 기계가 읽는 경로에서는 가려진 글을 아예 뺐다.
다 만들고 나니 Jev가 나왔다
그렇게 구현을 다 하고 나니 Jev 소식으로 떠들썩했다.
Jev는 TypeSafe AI가 내놓은 첫 "System One 모델"이다. 텍스트를 생성하는 LLM이 아니다. 미리 정해 둔 타입의 값, 예를 들면 예/아니오 확률이나 선택지 중 하나를 돌려준다. 토큰을 하나씩 이어 붙이지 않고 한 번에 출력을 뽑기 때문에 응답이 70~500ms 사이에 끝난다고 한다. 가격도 파격적이다. 입력은 100만 토큰당 $0.042이고 출력은 무료다.
스팸 판정은 사실상 이진 분류다. 문장을 쓸 필요가 없고 확률 하나면 충분하다. 딱 Jev가 잘하겠다는 일이다.
가격 비교
공식 가격표 기준으로 비교하면 이렇다(100만 토큰당, 표준 요금).
| 입력 | 출력 | |
|---|---|---|
OpenAI gpt-5.6-luna | $0.20 | $1.20 |
TypeSafe jev | $0.042 | 무료 |
입력 단가만 보면 Luna가 약 4.8배 비싸다. 실제 차이는 이보다 크다. Luna는 추론 모델이라 reasoning_effort=low로 줘도 추론 토큰이 나오고, 이게 출력 토큰으로 과금된다. 출력 단가는 입력의 6배다. Jev는 출력이 아예 무료다.
글 1만 건을 판정한다고 치고 대략 계산해봤다. 토큰 수는 짐작으로 잡은 값이다.
- Luna: 입력 1,000토큰(시스템 프롬프트 + 글), 출력 250토큰(추론 + JSON)
- Jev: 입력 800토큰(질문·기준 + 글), 출력 없음
| 입력 비용 | 출력 비용 | 합계 | |
|---|---|---|---|
| Luna | 1,000만 토큰 × $0.20 = $2.00 | 250만 토큰 × $1.20 = $3.00 | $5.00 |
| Jev | 800만 토큰 × $0.042 = $0.34 | $0 | $0.34 |
이 가정에서는 15배 정도 차이가 난다. Luna도 1만 건에 $5면 충분히 싸다. K-DEVCON 규모에서는 어느 쪽이든 커피 한 잔 값도 안 된다. 그래도 호출이 많아지는 서비스라면 이 차이가 커진다.
다만 TypeSafe 스스로도 이 가격이 지속 가능한지는 아직 증명하지 못했다고 밝히고 있다. 지금 가격이 영원하리라 믿고 Luna를 걷어내기보다는, 뒤에서 다룰 폴백으로 남겨 두기로 했다.
그래도 이 정도 차이면 안 써볼 이유가 없어서 붙여보기로 했다.
코드는 먼저, 계정은 나중에
문제는 계정이었다. Jev에 사람이 너무 몰려 대기자 명단에 이름을 올리고 차례를 기다려야 했다. 계정이 없으니 API 키도 받을 수 없었다.
그렇다고 손 놓고 기다리기는 아까워서 구현은 문서만 보고 먼저 해 뒀다. 요청·응답 형식은 문서에 나온 대로 맞춰뒀다.
그렇게 한동안 마무리를 못 짓고 있었는데, 오늘 아침 메일이 왔다.
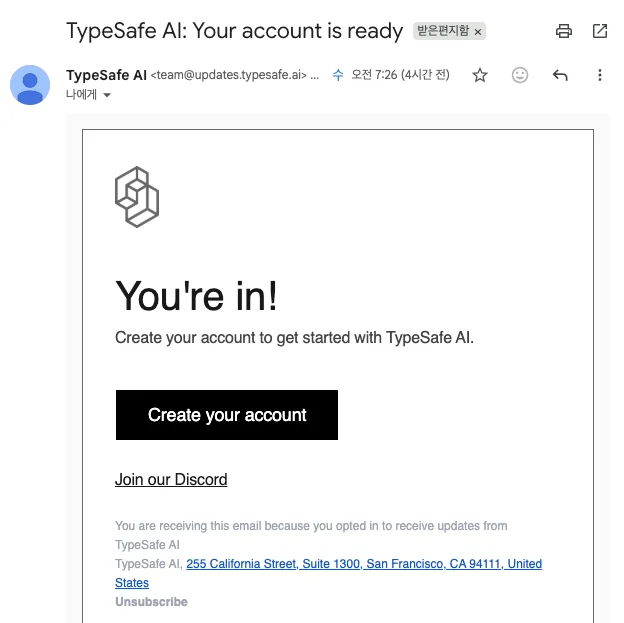
"You're in!" 드디어 계정을 만들 수 있게 됐다.
Jev에 스팸 여부 묻기
Jev API는 채팅 모델과 규약이 완전히 다르다. 평가 대상인 state와 무엇을 물을지인 questions가 따로 있다. 스팸 판정에는 예/아니오 질문 타입인 noul을 쓴다.
{
  "model": "jev-latest",
  "state": "[제목]\n급전 필요하신 분\n\n[본문]\n카톡 ID: money123 문의주세요",
  "questions": {
    "spam": {
      "type": "noul",
      "instructions": "이 글은 한국 개발자 커뮤니티에서 가려야 할 스팸인가?",
      "criteria": {
        "true": "커뮤니티 주제와 무관한 상업적 광고(대출, 도박, 성인물, 의약품, 코인 리딩방). ...",
        "false": "채용 공고, 스터디·사이드프로젝트 모집, 행사·밋업 홍보. 자기 블로그·깃허브·발표 자료 공유. ..."
      }
    }
  }
}
응답의 answers.spam.noul에 "예"일 확률이 숫자 하나로 온다.
기존 프롬프트를 옮기면서 달라진 점이 몇 가지 있다.
- "애매하면 스팸이 아니다"는 옮기지 않았다. Jev에서는 그 역할을 임계값이 한다. 애매한 글은 0.5 근처 확률을 받고 그 값은 가림 기준(게시글 0.85)을 넘지 못한다. 프롬프트로 부탁하던 걸 숫자로 강제하게 된 셈이다.
- 오탐 예시는 그대로 옮겼다. 채용 공고나 스터디 모집은 어느 모델이든 따로 알려주지 않으면 걸러낸다.
criteria.false쪽에 넣었다. - 가림 사유 문장이 없다. Jev는 문장을 못 쓴다. Jev가 가린 글에는 "스팸으로 자동 판정되었습니다." 같은 고정 문구가 들어간다. 모델마다 사유가 흔들리지 않는다는 점에서는 오히려 낫다.
- 프롬프트 인젝션 여지가 좁다. 채팅 모델에서는 지침과 글이 같은 대화에 섞여 들어가지만 Jev에서는
state가 평가 대상일 뿐이다. 본문에 무엇을 써도 질문 자체를 바꾸지는 못한다.
채팅 모델은 스팸 여부(spam)와 확신도(confidence)를 따로 주는데, Jev는 확률 하나뿐이다. 판정 결과 객체는 기존 형태를 유지하고 싶어서 spam = p >= 0.5, confidence = p로 매핑했다. 임계값이 0.5 이상이기만 하면 결국 "확률이 임계값을 넘으면 가린다"와 같아진다. 임계값을 0.5 미만으로 설정하면 두 엔진의 동작이 갈리기 때문에 기동 시점에 막아 두었다.
응답이 이상할 때도 조심해야 한다. noul 값이 없거나 0~1 밖이면 0.0으로 떨어뜨리지 않고 판정 실패로 처리한다. 0.0으로 두면 "확실히 스팸이 아니다"라는 판정이 있었던 것처럼 보여서 뒤에 나올 폴백도 알림도 걸리지 않는다.
Jev 1차, Luna 폴백
Luna를 걷어내지는 않았다. 가격이 계속 유지될지도 모르고 Jev는 이제 막 early access를 연 서비스라 얼마나 안정적일지도 아직 모른다. 그래서 Jev를 1차로 두고 호출이 실패하면 Luna가 받아서 다시 판정하는 폴백 구조로 만들었다.
private SpamVerdict route(...) {
  if (!jevProperties.isEnabled()) {
    return call.apply(openAiClassifier);
  }

  final SpamVerdict primary = call.apply(jevClassifier);
  if (!primary.isUnavailable()) {
    fallbackNotified.set(false);
    return primary;
  }

  final SpamVerdict fallback = call.apply(openAiClassifier);
  ...
}
정한 규칙은 이렇다.
폴백 조건은 "호출 실패"뿐이다. 예외, 타임아웃, HTTP 에러, 응답 파싱 실패일 때만 넘어간다. Jev가 답을 주면 확률이 아무리 애매해도 그 결과를 쓴다. 애매한 건만 Luna에 다시 묻는 방식도 생각해봤지만 그러면 같은 글이 두 모델의 서로 다른 기준으로 판정된다. 임계값 하나로 동작을 설명할 수 없게 된다.
판정기는 예외를 던지지 않는다. 실패는 전부 "판정 못 함"이라는 반환값으로 돌려준다. 폴백은 예외가 아니라 이 값을 보고 넘어간다. 두 엔진이 모두 실패하면 글은 그대로 둔다(fail-open). 모델이 죽어 있는 동안 올라온 글을 전부 가릴 수는 없다.
타임아웃은 짧게 잡았다. Luna는 20초, Jev는 5초다. Jev는 대부분 100ms대에 답하니 5초를 넘기면 사실상 장애다. 여기에 20초를 주면 Jev가 죽어 있는 동안 한 건마다 20초를 버린 뒤에야 폴백으로 넘어가고 그만큼 판정용 스레드 풀이 묶인다.
폴백은 조용한 고장이다. 폴백이 걸려도 판정은 멀쩡히 나오고 가림 동작도 같다. 달라지는 건 속도와 비용뿐이라 아무도 모르고 지나가기 쉽다. 그래서 판정 알림에 판정: Jev / 판정: OpenAI를 붙이고 폴백이 걸리면 따로 알린다. 장애 동안 글마다 알림이 쏟아지지 않게 첫 건만 보내고 Jev가 한 번이라도 성공하면 다시 알릴 수 있도록 풀어 준다.
키를 넣고 돌려보니
계정을 만들고 API 키를 넣은 뒤 바로 테스트해 봤다. 테스트용으로 간단하게 두 번만 돌려 봤는데, 스팸 글은 빠르게 잘 잡혔다.
판정 모델 호출은 OpenTelemetry로 지연과 토큰 사용량을 남기고 있어서 대시보드에서 바로 확인할 수 있다.
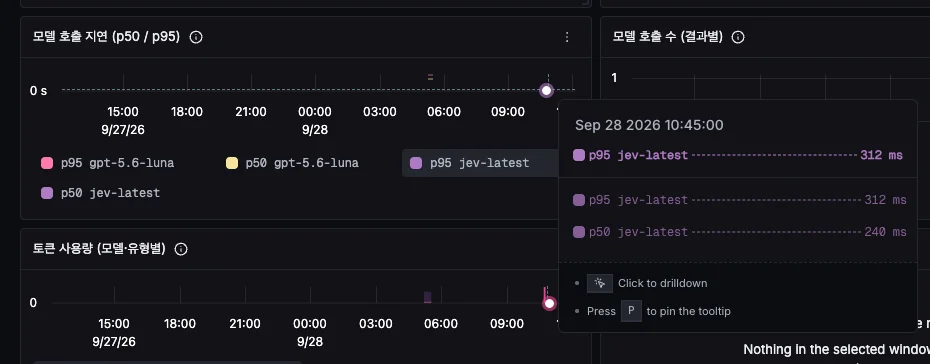
p50이 240ms, p95가 312ms였다. TypeSafe가 발표한 70~500ms 범위 안이다. 사실 판정은 글이 저장된 뒤 백그라운드에서 비동기로 돌기 때문에, 아주 느리지만 않으면 속도는 크게 상관없다.
토큰 사용량도 같은 대시보드에 찍힌다.
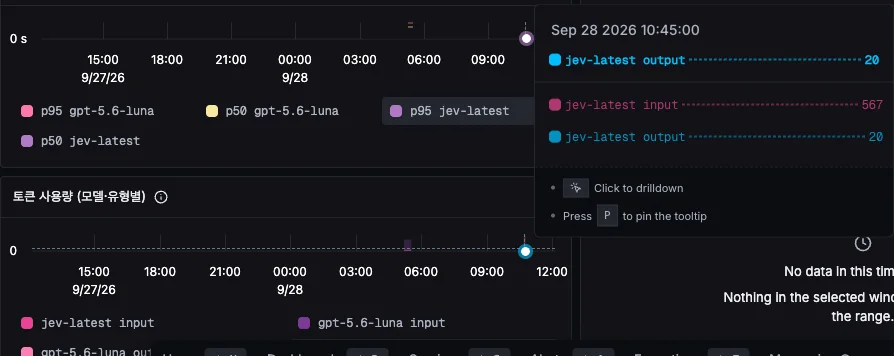
캡처는 두 번 중 한 건으로, 입력 567토큰에 출력 20토큰이었다. 출력 토큰도 집계는 되지만 Jev는 출력이 무료라 과금되지 않는다.
테스트가 끝난 뒤 TypeSafe 대시보드도 열어 봤다.
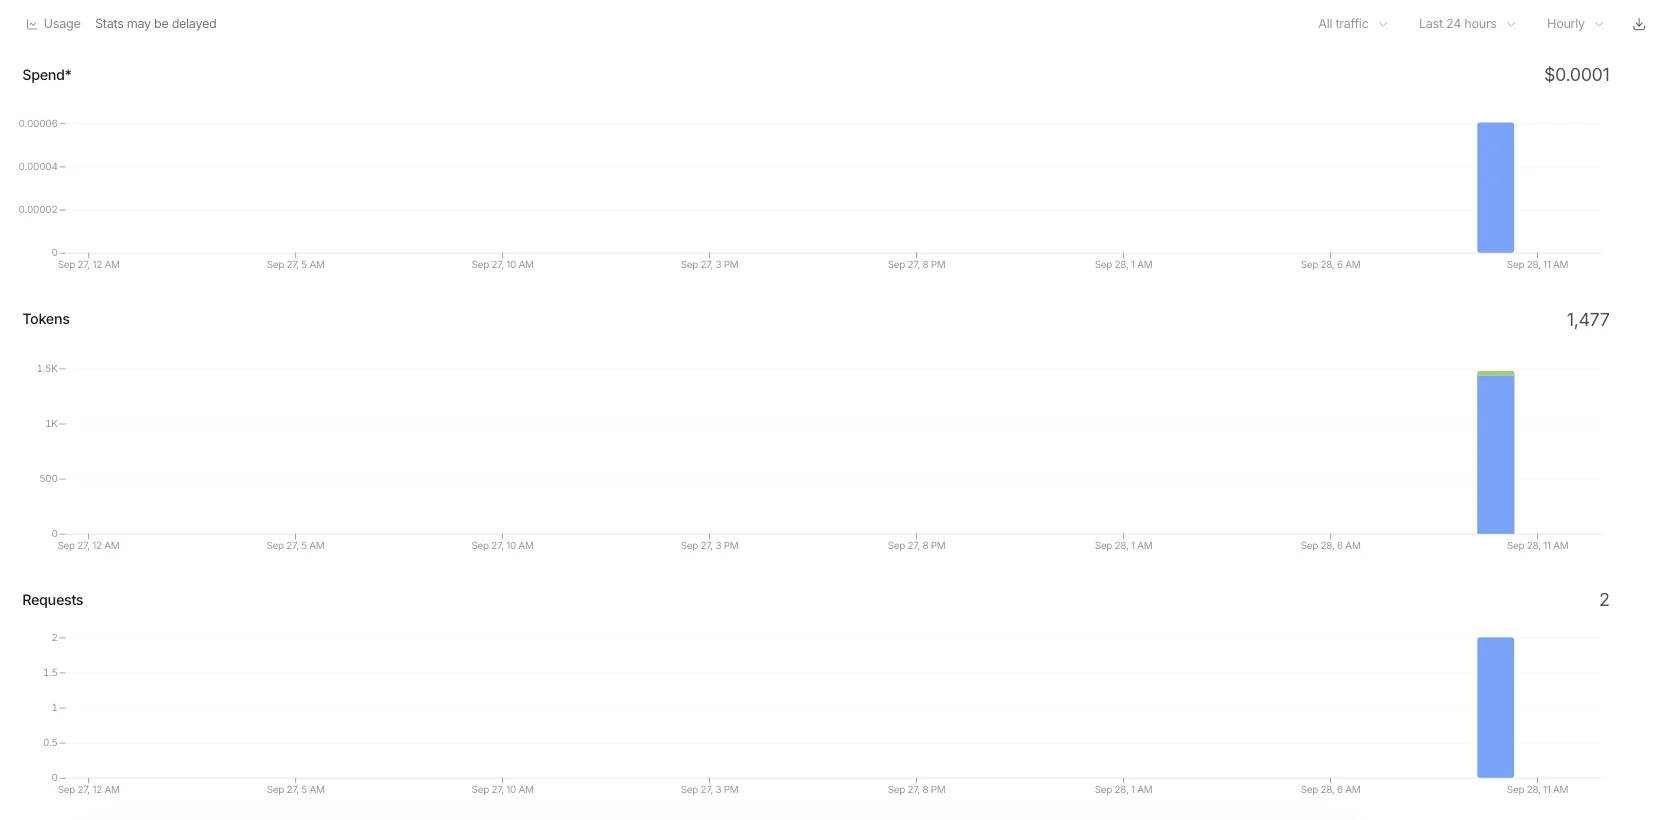
요청 2건에 1,477토큰을 썼고 비용은 $0.0001로 찍혔다. 이것도 반올림된 값이고 그래프를 보면 실제로는 $0.00006 정도다. 입력 단가 $0.042/MTok으로 계산한 값과 거의 같다.
두 건 합쳐 1,477토큰이니 한 건에 평균 740토큰 정도다. 위의 한 건이 입출력 합쳐 587토큰이었으니 나머지 한 건은 900토큰 가까이 쓴 셈이다. 판정할 글이 길수록 토큰도 늘어난다. 앞에서 가격을 비교할 때 한 건에 800토큰으로 짐작했는데 실제와 크게 다르지 않았다. 평균 740토큰으로 잡으면 1만 건을 판정해도 $0.3 남짓이다.
마치며
기술적으로 Jev가 엄청난 혁신이라고는 생각하지 않는다. 결국 분류 모델이고 구조화된 출력이나 확률을 주는 방법은 전에도 있었다.
그래도 사용자 입장에서는 의미가 있다. 직접 모델을 학습시키거나 서빙할 필요 없이, 자연어로 질문과 기준만 적으면 저렴하고 빠르게 판단을 받을 수 있는 수단이 생겼다. 텍스트 생성이 필요 없는 일에 LLM을 쓰면서 출력 토큰 값을 치르던 부분을 덜어낼 수 있다.
당분간은 Jev 1차, Luna 폴백 구조로 운영해 보면서 판정 결과와 폴백 빈도를 지켜볼 생각이다.