[Review] 박종훈의 AI 논문 스터디 - 4주차 후기
안녕하세요! K-DEVCON 그로스 매니저 박종훈입니다.
AI 논문 스터디 네 번째 시간이 9월 21일(월)에 있었습니다.
(3주차 후기 보러가기)
지난 시간에는 4장 앞부분에서 RNN과 LSTM을 읽었습니다. 4장은 분량이 많아 둘로 나눠 읽기로 했고, 이번에 나머지 부분을 봤습니다.
- Recurrent Neural Network Regularization (2014) — RNN에 드롭아웃을 어떻게 걸 것인가
- Deep Speech 2 (2015) — 순환 신경망으로 만든 음성 인식
이번 장을 읽으면서 RNN 구조의 한계를 볼 수 있었고, RNN이 왜 자리를 내줄 수 밖에 없었는지 이해할 수 있었습니다.
---
Recurrent Neural Network Regularization (2014)
Regularization과 Normalization은 어떤 차이가 있는가
첫 논문 제목이 "Recurrent Neural Network Regularization"인데, 한국어 번역으로는 regularization과 normalization이 모두 "정규화" 로 옮겨져 둘이 비슷한 느낌으로 읽힙니다. 그래서 먼저 용어를 정리해보았습니다.
| 영어 | 하는 일 | 예시 | 적절한 우리말 |
| ------------------ | ------------------------------------------------------- | ---------------------------- | ------------- |
| Regularization | 모델이 학습 데이터에 너무 달라붙지 않게 제약을 건다 | 드롭아웃, L1/L2, 가중치 감쇠 | 규제, 정칙화 |
| Normalization | 값의 범위나 분포를 고르게 맞춘다 | 배치 정규화, 레이어 정규화 | 정규화 |
둘은 목적이 아예 다릅니다. regularization은 오버피팅을 막는 것이 목표고, normalization은 학습이 안정적으로 진행되도록 값을 다듬는 것이 목표입니다. 스터디에서는 "regularization은 규제로 읽는 게 낫겠다"는 쪽으로 정리했습니다.
RNN에 드롭아웃을 어떻게 걸까
드롭아웃은 학습할 때마다 뉴런 일부를 무작위로 꺼버리는 기법입니다. 2장 AlexNet 에서 이미 본 개념이죠. 특정 뉴런에만 의존하지 못하게 만들어서 오버피팅을 막습니다.
그런데 이걸 RNN에 도입하려고 하니 잘 되지 않았습니다. 이 논문은 그 이유와 해결책을 다룹니다.
순환 경로를 끊으면 기억이 사라진다
지난 시간에 본 것처럼 RNN은 같은 모듈 하나를 시점마다 반복해서 쓰고, 그 사이를 히든 스테이트가 흐릅니다. 여기서 뉴런을 무작위로 끈다는 것은 앞에서 읽은 내용을 무작위로 지운다는 뜻이 됩니다.
스텝 1        스텝 2        스텝 3        스텝 4
  h1  ───────→  h2  ───────→  h3  ───────→  h4
      ✂ 20%        ✂ 20%        ✂ 20%
한 스텝에서 20%를 지우는 것으로 끝나지 않습니다. 100단어짜리 문장이면 이 가위질이 100번 반복됩니다. 첫 단어의 정보가 마지막까지 살아남을 확률은 사실상 0에 수렴합니다. 지난 시간에 LSTM이 셀 스테이트라는 통로까지 따로 만들어 가며 지키려 했던 것을, 드롭아웃이 앞장서서 부수는 셈입니다.
그래서 세로 방향에만 겁니다
논문의 해결책은 단순합니다. 순환 연결(가로)에는 걸지 않고, 층과 층을 잇는 비순환 연결(세로)에만 겁니다.
        스텝 1       스텝 2       스텝 3
출력      ↑            ↑            ↑
         ✂            ✂            ✂        ← 드롭아웃 (세로)
2층    LSTM ──────→ LSTM ──────→ LSTM
         ↑            ↑            ↑
         ✂            ✂            ✂        ← 드롭아웃 (세로)
1층    LSTM ──────→ LSTM ──────→ LSTM
         ↑            ↑            ↑
입력    x1           x2           x3

        가로 화살표(히든 스테이트)에는 걸지 않는다
이렇게 하면 정보는 시간 축을 따라 온전히 흐르면서 층을 건너 올라갈 때마다 규제를 받습니다. 정보가 거치는 드롭아웃 횟수가 문장 길이와 무관하게 층 수만큼으로 고정됩니다.
간단한 아이디어지만 효과는 컸습니다. 이 논문 덕분에 드롭아웃을 쓴 큰 LSTM을 오버피팅 없이 학습시킬 수 있게 됐고, 언어 모델·음성 인식·기계번역·이미지 캡션 생성까지 여러 과제에서 성능이 올랐습니다.
그런데 이 결론은 부분적으로 틀렸습니다
책에는 이 이후 이야기가 나오지 않는데, 조금 더 찾아보니 이 결론은 나중에 부분적으로 뒤집혔습니다.
논문이 남긴 명제는 "순환 연결에 드롭아웃을 걸지 마라"로 굳어졌습니다. 그런데 범인은 드롭아웃을 건 위치가 아니라 마스크를 다시 뽑는 행위였습니다. (Gal & Ghahramani(2016))
RNN은 모든 타임스텝에서 같은 가중치 W를 공유합니다. 그게 RNN의 정의입니다.
그런데 드롭아웃은 원래 "여러 모델을 무작위로 뽑아 번갈아 학습시키는 것" 에 가까운 기법입니다. 유닛 몇 개를 끄면 조금씩 다른 모델이 하나 만들어지는 셈이니까요.
그런데 매 스텝 마스크를 새로 뽑게 되면 한 문장을 처리하는 도중에 스텝마다 다른 모델을 갈아 끼우는 것이 됩니다. 학습 중에는 같은 모델이 유지되지 못하고 중간중간 계속 바뀌게 됩니다.
그래서 Gal의 해법은 가로든 세로든 가리지 않고 끌 유닛을 한 번 뽑아서 그 유닛을 시퀀스 처음부터 끝까지 비활성화하는 것입니다. 다음 시퀀스가 들어오면 그때 다시 무작위로 뽑아 마스크를 구성합니다.
이렇게 하면 앞에서 본 문제가 사라집니다. 꺼진 유닛은 처음부터 없었던 것처럼 일관되게 빠져 있으니 살아남은 경로로는 정보가 첫 스텝부터 끝까지 온전히 흐를 수 있게 되었습니다.
최종적으로 결과도 더 좋게 나왔습니다.
그런데 여기서 재밌는 부분이 한 가지 더 있습니다. 이 방법이 더 좋은 결과를 냈음에도 오늘날 프레임워크의 기본값은 여전히 비순환 연결에만 드롭아웃을 겁니다.
그 이유는 비순환 연결에만 거는 쪽이 구현이 단순하고, 하드웨어 최적화 경로를 탈 수 있기 때문입니다. 정확도를 조금 올리자고 학습 시간을 몇 배로 늘릴 것인가를 따져보고 속도를 택한 사례입니다.
Deep Speech 2 (2015)
아이스브레이킹 — 이 논문의 저자
책을 읽다가 재밌는 부분이 있었습니다. 이 논문은 바이두에서 냈고, 저자 중 한 명이 지금 Anthropic의 CEO인 다리오 아모데이입니다.
이력을 따라가 보면 이렇습니다.
바이두 (Deep Speech 2) → 구글 브레인 → OpenAI → Anthropic 공동창업 (2021)
아모데이는 왜 바이두에 있었을까요? 당시 바이두의 수석 과학자가 앤드류 응이었습니다. 스타 연구자가 있는 곳으로 움직였다는 것이였습니다.
문제를 다시 정의하다
Deep Speech 2는 새 아이디어를 낸 게 아니라 1편의 핵심 아이디어를 그대로 두고 확장해서 개선한 논문입니다.
예전의 음성 인식 연구는 욕심이 컸습니다. 말을 걸면 알아듣고 적절히 답하는 것까지 한 번에 하려고 했지만 잘 되지 않았습니다.
Deep Speech 2는 목표를 좁혔습니다. "일단 들린 말을 정확히 텍스트로 옮기는 것", 딱 거기까지만 합니다. 대신 그걸 처음부터 끝까지 하나의 신경망(end-to-end) 으로 합니다.
이전 음성 인식 시스템은 음향 모델, 발음 사전, 언어 모델을 따로 만들어 이어 붙인 파이프라인이었습니다. 각 부품마다 전문 지식이 필요했고 언어가 바뀌면 다시 만들어야 했죠. Deep Speech 2는 그 조각들을 한 덩어리로 대체합니다. 실제로 같은 구조로 영어와 중국어를 둘 다 학습시켰다는 점이 논문 제목에도 들어가 있습니다.
음성은 어떤 데이터가 되나
"이미지는 픽셀, 텍스트는 토큰인데, 소리는 뭐로 바꿔 넣나요?"라는 질문이 나왔습니다.
답은 스펙트로그램입니다. 소리를 짧은 구간으로 잘라 각 구간에 어떤 주파수가 얼마나 섞여 있는지를 구하고 그걸 나란히 놓습니다.
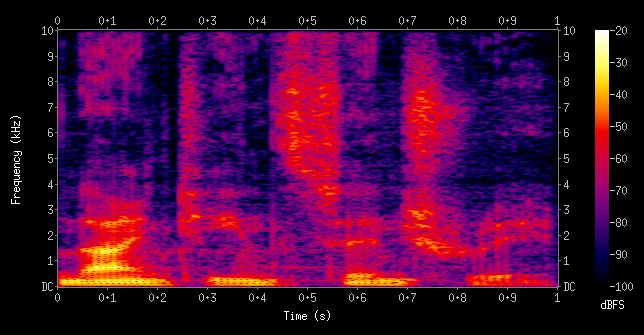 "nineteenth century"를 발음한 스펙트로그램. 가로가 시간, 세로가 주파수이고 색이 밝을수록 그 주파수의 소리가 세다. 출처: 위키피디아
이렇게 두면 소리가 2차원 배열이 됩니다.
SortaGrad — 왜 첫 에폭만 정렬할까
논문에 SortaGrad라는 기법이 나옵니다. 학습 데이터를 첫 에폭에만 짧은 것부터 긴 순서로 정렬해서 넣고 그다음부터는 평소처럼 섞습니다.
"왜 계속 정렬하지 않고 첫 에폭만?"이라는 질문이 자연스럽게 나왔습니다. 답은 둘 다 필요하기 때문이었습니다.
첫 에폭을 정렬하는 이유 — 커리큘럼 러닝
사람이 쉬운 것부터 배우듯 모델에게도 쉬운 데이터부터 주는 방식을 커리큘럼 러닝이라고 합니다. 시퀀스 데이터에서는 그 난이도 기준이 길이입니다. 긴 음성은 초반의 불안정한 모델에게 특히 가혹해서 학습 초기에 이것부터 만나면 값이 발산해버리기 쉽습니다.
기초를 다지고 단계적으로 올라가면 얕은 웅덩이(로컬 미니멈)에 빠지지 않고 더 깊은 곳까지 내려갈 수 가능성이 높아집니다.
계속 정렬하면 안 되는 이유 — SGD의 전제
경사하강법은 매번 데이터가 무작위로 섞여 들어온다는 전제 위에 서 있습니다. 계속 길이순으로 넣으면 배치마다 성격이 치우쳐서 그 전제가 깨집니다. 그래서 초반에 틀을 잡는 용도로 한 번만 쓰고 이후에는 섞는 것입니다.
덤으로 따라오는 것 — 패딩 낭비
길이가 제각각인 데이터를 한 배치에 묶으려면 가장 긴 것에 맞춰 나머지를 빈칸(패딩)으로 채워야 합니다.
섞어서 배치           길이순으로 배치
┌──────────────┐     ┌──────────────┐
│ 480  ████░░░░│     │ 470  ████████│
│ 1800 ████████│     │ 480  ████████│
│ 520  ████░░░░│     │ 490  ████████│
│ 1750 ████████│     │ 510  ████████│
└──────────────┘     └──────────────┘
  ░ = 낭비되는 계산     낭비가 거의 없다
비슷한 길이끼리 모아두면 이 빈칸이 확 줄어듭니다. 정확도를 위한 기법이 연산 효율까지 같이 챙겨주는 셈입니다.
다만 주의할 부분이 있습니다. 짧은 문장이 곧 의미적으로 쉬운 것은 아니기 때문에, 항상 짧은 것부터 넣는 게 좋은 방법도 아닙니다.
Sequence-wise Batch Normalization
정규화 이야기가 다시 나옵니다. 논문은 RNN에 배치 정규화를 적용하면서 통계를 내는 범위를 손봅니다.
이미지에서 쓰던 배치 정규화는 보통 채널(피처 맵) 단위로 평균과 분산을 구합니다. 그런데 시퀀스 데이터는 시간 축이 하나 더 있습니다. Deep Speech 2는 이 시간 축 전체를 함께 묶어 통계를 냅니다.
일반 배치 정규화              시퀀스 단위 배치 정규화
각 시점을 따로 본다           시간 축 전체를 묶어서 본다
 t1   t2   t3                 t1   t2   t3
 ▣    ▣    ▣                 └─────▣─────┘
스터디에서는 한 참여자분은 이런 이야기도 해주셨습니다.
정규화 기법이 많은 이유는 계산이 달라서가 아니라 어느 범위를 묶어서 볼 것인가가 다르기 때문입니다. 입력 데이터의 성격에 맞게 그 범위를 고르는 것이 중요합니다.
실시간성 — 양방향 RNN의 딜레마
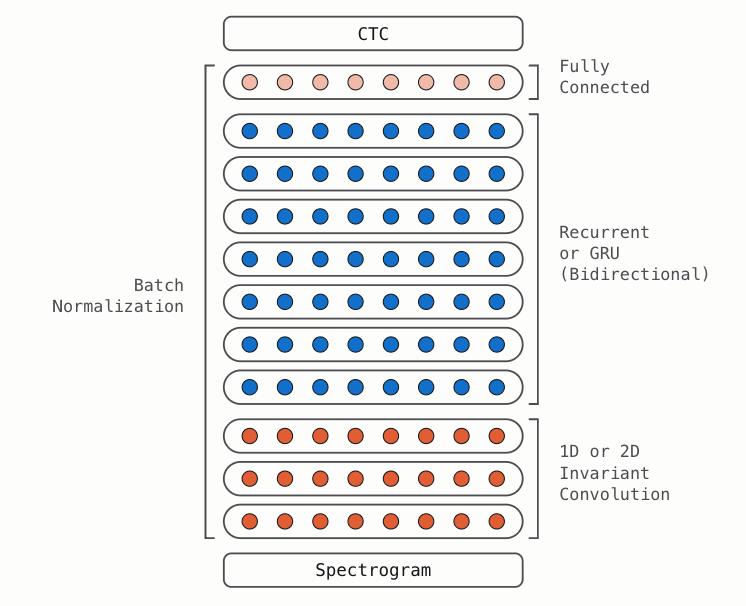 Deep Speech 2 의 아키텍처
정확도를 올려보기 위해 논문에서 양방향 RNN을 사용합니다. 문장을 앞에서 뒤로 한 번, 뒤에서 앞으로 한 번 읽어 양쪽 문맥을 모두 보는 구조입니다. "나는 \_\_\_ 먹었다"에서 빈칸 뒤의 "먹었다"까지 보고 판단할 수 있으니 당연히 정확합니다.
문제는 뒤를 보려면 끝까지 기다려야 한다는 것입니다.
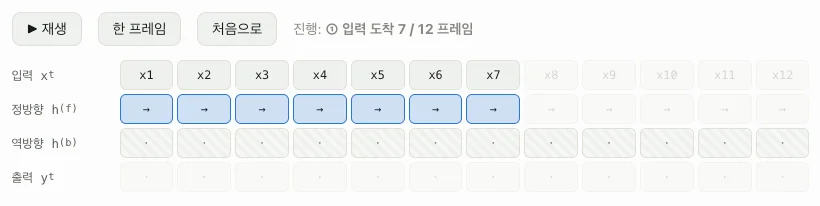 입력이 들어오는 동안 정방향은 계산되지만, 출력은 아직 하나도 나오지 않습니다.
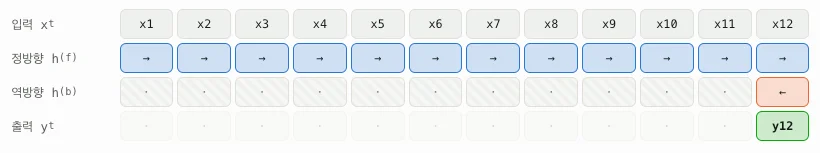 마지막 프레임이 들어와야 역방향 계산이 시작됩니다. 제일 먼저 확정되는 출력은 맨 끝의 y12입니다.
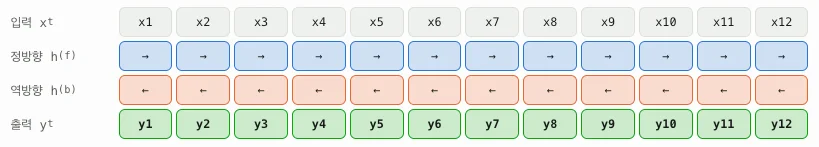 역방향이 처음까지 되돌아오고 나서야 첫 출력 y1이 나옵니다. 하나를 얻으려고 전부를 기다린 셈입니다.
그래서 배포용 모델은 단방향 + 행 합성곱(row convolution) 으로 갑니다. 뒤 전체가 아니라 앞으로 몇 프레임 정도만 더 보고 바로 결과를 내는 방식입니다. 미래를 조금만 빌려오는 절충안이죠.
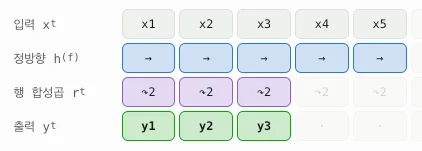 앞으로 두 프레임만 더 보고 y1을 바로 냅니다. 뒤가 다 들어오지 않아도 출력이 흘러나옵니다.
논문에서는 정확도를 위해 양방향을 쓰고 실제 제품에서는 다른 구성으로 간다는 점이 인상적입니다. 실제로 회사가 제품/서비스를 만들면서 쓴 논문이라는게 느껴지는 부분이였습니다.
그 외에 나온 이야기들
이번 시간은 유난히 곁가지가 길었습니다. 본론에서 흘러나온 질문이 엉뚱한 데까지 번졌는데, 그중 몇 개는 묘하게 한 줄기로 이어졌습니다.
RNN은 몇 층까지 쌓을 수 있을까
드롭아웃을 세로 방향에 건다는 말이 나오면서 "그럼 RNN은 몇 층까지 쌓나"로 이야기가 넘어갔습니다.
찾아보니 두 층만 넘어가도 학습이 잘 되지 않고, 네 층 정도가 현실적인 한계였다고 합니다. CNN에서 수십, 수백 층을 쌓던 것과 대비됩니다.
여기서 지난 시간에 본 ResNet이 다시 등장합니다. 구글이 기계번역 모델(GNMT)을 만들면서 LSTM 층 사이에 레지듀얼 연결을 붙여 8층까지 쌓아 올렸습니다. 층을 건너뛰는 지름길을 만들어 깊이의 한계를 밀어낸 것인데, ResNet이 CNN에서 했던 일과 정확히 같습니다.
그래도 남는 한계
구조를 손봐서 깊이를 늘려도 RNN 자체의 한계는 그대로 남습니다.
CNN은 층마다 파라미터가 따로 있어서 층을 쌓으면 모델의 용량이 함께 늘어납니다. 반면 RNN은 모든 스텝이 같은 가중치 한 벌을 돌려 씁니다. 문장이 아무리 길어져도 기억을 담는 그릇의 크기는 처음 정한 그대로입니다.
그러니 문장이 길어지면 그릇이 넘칩니다. 층을 아무리 쌓아도 이 구조적 제약은 해결되지 않습니다. 트랜스포머는 이 문제를 그릇을 키우는 대신 원본을 매번 다시 보는 방식으로 우회했습니다. 5장에서 볼 이야기입니다.
그런데 요즘 다시 보는 흐름도 있습니다
반대 방향 이야기도 나왔습니다. 트랜스포머 계열이 토큰과 GPU를 너무 많이 먹다 보니 경량화나 토큰 절감을 노리고 RNN·LSTM 계열을 다시 연구하는 움직임이 있다는 것입니다.
RNN은 스텝마다 고정된 크기의 상태 하나만 들고 가면 되니 메모리가 입력 길이와 무관합니다. 트랜스포머가 KV 캐시로 앞 토큰을 전부 들고 있어야 하는 것과 정반대죠. 길이가 길어질수록 이 차이는 커집니다.
LSTM의 "기억"은 어디에 있나
지난 시간에 본 LSTM의 셀 스테이트를 흔히 "장기 기억"이라고 부릅니다. 여기서 "그게 컴퓨터 메모리인가요? 램이 따로 있는 건가요?"라는 질문이 나왔습니다.
답은 "아니오"입니다. 셀 스테이트든 히든 스테이트든 그냥 숫자 배열이고 계산하는 동안 GPU 메모리에 올라가 있을 뿐입니다. "기억"은 비유이지 저장 장치가 아닙니다.
다만 이 질문에서 재미있는 갈래가 나왔습니다. 모델에 진짜 메모리를 붙이면 어떨까를 시도한 연구가 있다는 것입니다. NTM(Neural Turing Machine) 이라고, 신경망에 외부 메모리를 달고 어디를 읽고 쓸지까지 학습하게 만든 구조입니다. 튜링 머신이 "규칙 + 무한한 테이프"로 무엇이든 계산할 수 있다면, 신경망에도 테이프를 쥐여주면 어떻게 되는가 하는 발상입니다.
노래 찾기는 AI가 아니었습니다
스펙트로그램 이야기를 하다 보니 카페에서 흘러나오는 노래를 찾아주는 기능은 어떻게 동작할까 궁금해져서 찾아본 분이 계셨습니다. 결과는 예상 밖이었습니다.
CNN으로 특징을 뽑아 저장할 거라고 생각했는데, 실제로는 머신러닝이 아니었습니다. 노래마다 스펙트로그램에서 두드러지는 지점들을 골라 주파수 지문(핑거프린트) 을 만들고, 그걸 해시로 DB에 넣어둔 뒤 들어온 소리에서 같은 지문을 뽑아 매칭합니다. 신호처리와 해시 테이블이 전부입니다.
주파수를 뽑는 데는 푸리에 변환(FFT) 이 쓰입니다. 시끄러운 카페에서도 찾아내는 건 소음을 걸러서가 아니라 지문 몇 개만 맞아떨어져도 곡을 특정할 수 있게 설계했기 때문입니다.
그럼 냄새는요?
"소리는 스펙트로그램으로, 이미지는 픽셀로, 텍스트는 토큰으로 바꾼다면 냄새는?"이라는 질문이 나왔습니다.
냄새도 마찬가지로, 강도에 따라 표현할 수 있을 것 같다고 이야기를 한 후, 찾아보니 전자코와 전자혀가 실제로 있습니다. 여러 화학 센서를 배열로 깔아두고 어떤 센서가 얼마나 반응했는지 그 패턴을 지문처럼 쓰는 방식입니다.
결국 문제는 현상을 어떻게 데이터로 표현하느냐 인 것 같습니다.
마무리
저희 스터디는 추석 연휴로 잠시 쉬어갑니다. 돌아오는 다음 모임에서는 드디어 어텐션과 트랜스포머를 다룹니다.
이번 시간에 나온 질문들이 대부분 5장을 가리키고 있었습니다.
- 고정 크기 벡터라는 병목을 어텐션은 어떻게 푸는가
- 병렬 계산이 안 된다는 RNN의 한계를 어떻게 넘는가
- 대신 치르는 비용은 무엇인가 (KV 캐시, O(N²) 연산량)
4장 내내 "정보를 어떻게 잃지 않고 끝까지 전달할까"를 고민했는데, 5장은 "처음부터 다 보면 되지 않나" 로 그 고민 자체를 뒤집습니다. 그 장면을 보려고 여기까지 온 셈입니다.
 참여해주신 분들 모두 고생 많으셨습니다. 추석 잘 보내시고, 10월에 뵙겠습니다.