[Review] 박종훈의 AI 논문 스터디 - 5주차 후기 (Transformer)
안녕하세요! K-DEVCON 그로스 매니저 박종훈입니다.
AI 논문 스터디 다섯 번째 시간이 10월 12일(월)에 있었습니다. 드디어 5장 어텐션과 트랜스포머를 읽었습니다. 이번에 읽은 논문은 Attention Is All You Need (2017) 입니다.
seq2seq — 어텐션이 필요해진 이유
어텐션이 왜 나왔는지 보려면 한 단계 앞의 seq2seq(Sequence to Sequence, 2014) 부터 보면 좋습니다. 4주차 끝에 가볍게 다뤘지만 지난 후기에는 담지 않아서 짧게 정리합니다.
seq2seq는 번역처럼 문장을 받아 다른 문장을 내놓는 문제를 RNN 두 개로 풉니다.
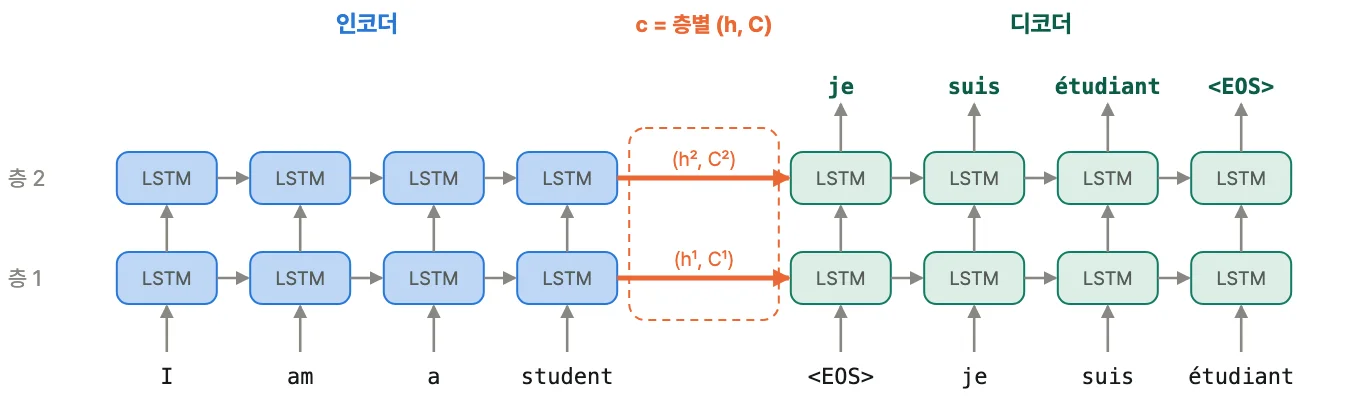
2층 LSTM으로 그린 seq2seq. 가로는 시간, 세로는 층입니다. (논문은 4층)
- 인코더(파란색)가 입력 문장을 처음부터 끝까지 읽고 마지막 상태에 문장 전체의 의미를 담습니다. 이 상태를 문맥 벡터 c라고 부릅니다.
- 디코더(초록색)는 그 c만 받아서 출력 문장을 한 단어씩 만듭니다. 방금 만든 단어를 다음 칸의 입력으로 다시 넣고, 끝을 뜻하는
EOS가 나오면 멈춥니다. - 가운데 주황색 화살표가 인코더와 디코더를 잇는 유일한 통로입니다. 층을 쌓으면 층마다 하나씩 넘어가지만, 입력 문장에 대해 디코더가 아는 것은 이게 전부입니다.
문제는 가운데의 고정 크기 벡터입니다. 다섯 단어짜리 문장이든 쉰 단어짜리 문장이든 같은 크기의 벡터 하나에 눌러 담아야 합니다. 문장이 길어질수록 앞부분의 정보가 흐려지고 번역 품질이 떨어집니다. 이런 한계 때문에 어텐션이 필요해졌습니다.
그래서 attention 이 도대체 뭔데?!
이름 그대로 "어디에 주목할 것인가" 입니다. 사람이 문장을 읽을 때를 떠올려 보면 쉽습니다.
그 동물은 길을 건너지 않았다. 그것은 너무 지쳐 있었기 때문이다.
"그것"을 읽는 순간 우리는 자연스럽게 앞의 "동물"을 다시 봅니다. "길"은 거의 신경 쓰지 않습니다. 단어 하나의 뜻을 정하려고 문장 안의 다른 단어들을 둘러보되, 관련 있는 단어에 더 많이 주목하는 것, 이게 어텐션입니다.
RNN과 비교하면 차이가 분명해집니다.
| RNN | 어텐션 | |
|---|---|---|
| 앞 단어 정보를 얻는 방법 | 히든 스테이트 하나에 차곡차곡 눌러 담아 넘긴다 | 필요할 때마다 원래 단어들을 직접 다시 본다 |
| 멀리 있는 단어 | 여러 스텝을 거치며 점점 흐려진다 | 거리와 상관없이 한 번에 본다 |
| 계산 순서 | 앞 단어가 끝나야 다음 단어를 계산한다 | RNN을 걷어내면 모든 단어를 동시에 계산할 수 있다 |
seq2seq에서 본 "벡터 하나에 다 눌러 담아야 한다"는 문제를, 어텐션은 벡터를 키우는 대신 매번 원본을 다시 보는 방식으로 풉니다.
결과만 보면 어텐션이 하는 일은 단순합니다. 단어마다 "문장의 모든 단어를 관련도만큼 섞은 새 벡터" 를 만듭니다. "그것"의 새 벡터에는 "동물"의 정보가 많이, "길"의 정보는 조금만 들어갑니다. 남는 질문은 하나입니다. 관련도를 어떻게 계산하는가. 이 답은 뒤에서 보겠습니다. 그 전에 어텐션이 처음 등장한 논문부터 살펴보겠습니다.
Bahdanau 어텐션 — 시작점이지만 아직 RNN
책은 Bahdanau 어텐션을 어텐션의 시발점으로 소개합니다. Bahdanau 어텐션은 벡터 하나 대신 입력 단어마다의 상태를 전부 넘기고, 디코더가 단어를 하나 만들 때마다 그중 어디를 볼지 가중치를 매기게 했습니다.
다만 이것만으로는 지금 우리가 아는 어텐션의 장점을 다 누리지 못했습니다. 인코더와 디코더는 여전히 RNN이라 단어를 하나씩 순서대로 처리해야 했습니다. seq2seq에서 둘 사이를 잇는 부분만 바꾼 셈입니다. 모든 단어를 한꺼번에 병렬로 계산하는 건 트랜스포머에 와서야 가능해집니다.
Attention Is All You Need (2017)
AI 공부를 따로 해본 적이 없더라도 이 제목은 한 번쯤 들어보셨을 겁니다. 내용은 몰라도 이름만큼은 유명합니다. Transformer 모델을 처음 제안한 논문으로, 2017년 구글 연구진이 발표했고 인용 수가 십만 회를 훌쩍 넘습니다. ChatGPT의 GPT도 Generative Pre-trained Transformer의 약자이니, 지금 쓰는 LLM은 거의 다 여기서 출발했다고 해도 과장이 아닙니다. 저희도 이름만 알던 논문을 이번에 처음으로 제대로 펼쳐 봤습니다.
먼저 전체 그림부터 보겠습니다. 이번 시간에 나온 이야기는 대부분 이 그림의 어느 한 칸에 해당합니다.
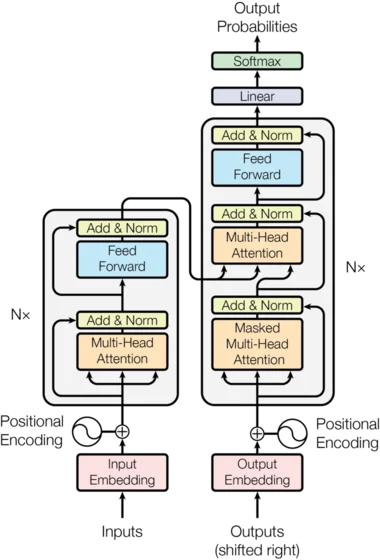
트랜스포머 아키텍처. 출처: Attention Is All You Need, Figure 1
왼쪽이 인코더, 오른쪽이 디코더입니다. 둘 다 회색 상자 하나를 N번 쌓은 구조이고 논문에서는 6번씩 쌓았습니다.
- 인코더: 입력 문장을 임베딩한 뒤 위치 인코딩을 더합니다. 그다음 멀티헤드 어텐션으로 단어끼리 정보를 섞고, 피드포워드로 단어 하나하나를 가공합니다.
- 디코더: 지금까지 만든 출력을 한 칸 밀어서(shifted right) 받습니다. 첫 어텐션은 미래 단어를 가린 Masked 멀티헤드 어텐션입니다. 두 번째 어텐션에는 인코더 쪽에서 화살표가 들어오는데, 이것이 인코더 결과를 가져오는 크로스 어텐션입니다. 마지막으로 Linear와 Softmax를 거쳐 다음 단어의 확률을 냅니다.
- 블록마다 붙어 있는 Add & Norm에서, 블록을 우회해 들어가는 화살표와 Add가 잔차 연결이고 Norm은 레이어 정규화입니다.
아래에서는 어텐션의 기본인 Q, K, V부터 시작해서 그림의 각 부분을 하나씩 살펴보겠습니다.
Scaled Dot-Product Attention
트랜스포머의 어텐션은 이 수식 한 줄로 정리됩니다.
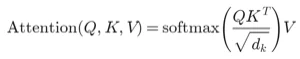
하나씩 풀어 보겠습니다. 핵심은 Q(Query), K(Key), V(Value) 세 벡터입니다. 문장에 들어온 토큰 하나하나는 벡터 x를 갖고 있고(첫 층에서는 임베딩, 그다음 층부터는 이전 층의 출력), 여기에 학습되는 가중치 행렬 세 개를 각각 곱해서 q, k, v를 만듭니다.
q = x · W_Q    내가 찾고 있는 것
k = x · W_K    나를 찾을 때 비교되는 꼬리표
v = x · W_V    실제로 건네줄 내용
같은 토큰에서 나온 벡터지만 쓰임이 다릅니다. 토큰 하나의 새 표현을 만드는 과정은 이렇습니다.
- 내 q를 문장 안 모든 토큰의 k와 각각 내적해서 점수를 구합니다. 방향이 비슷할수록 점수가 큽니다. 수식의 QKᵀ 부분입니다.
- 점수를 소프트맥스에 넣어 합이 1인 비중으로 바꿉니다. 수식의 softmax(…) 부분입니다.
- 그 비중대로 모든 토큰의 v를 섞어 더합니다. 이것이 내 토큰의 새 표현이 됩니다. 마지막에 V를 곱하는 부분입니다.
W_Q, W_K, W_V는 사람이 정해주지 않습니다. 학습하면서 "무엇을 찾을지", "어떤 꼬리표를 달지", "무엇을 건네줄지"가 자리를 잡습니다.
분모의 √d_k 는 스케일을 맞추는 용도입니다. 벡터 차원 d_k가 커질수록 내적 값도 커지는데, 그대로 소프트맥스에 넣으면 값 하나만 1에 가깝게 튀고 나머지는 0에 가까워져 학습이 잘 되지 않습니다. 그래서 차원의 제곱근으로 나눠 값의 크기를 맞춥니다.
멀티헤드 어텐션
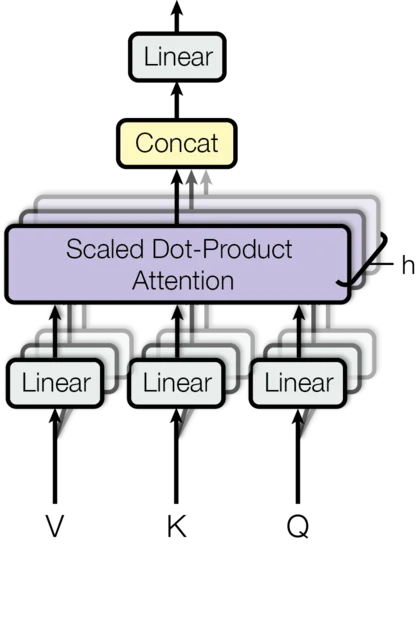
멀티헤드 어텐션. 출처: Attention Is All You Need, Figure 2
멀티헤드 어텐션은 Q, K, V를 만드는 가중치를 여러 벌 두고 각자 어텐션을 따로 계산하는 구조입니다. 그림에서 뒤로 겹쳐 보이는 상자들이 그 여러 벌이고, 오른쪽의 h가 헤드 개수입니다. 아래쪽 Linear가 헤드마다 Q, K, V를 따로 만들고, 가운데 Scaled Dot-Product Attention은 앞에서 본 수식 그대로입니다.
헤드마다 보는 관점이 다릅니다. 어떤 헤드는 주어를, 어떤 헤드는 목적어를 보는 식입니다. (실제로 그렇게 깔끔하게 나뉘지는 않고, 사람이 이해하기 쉽게 하기 위한 설명입니다.)
재밌었던 건 헤드별 결과를 합치는 방법입니다. 뭔가 정교한 방법이 있을 줄 알았는데 그림 위쪽처럼 그냥 이어 붙이고(Concat), 출력용 Linear로 한 번 더 변환하는 게 전부입니다.
The Annotated Transformer 코드를 따라가며 문장 2개, 토큰 10개짜리 입력의 모양 변화를 그려보면 다음과 같습니다.
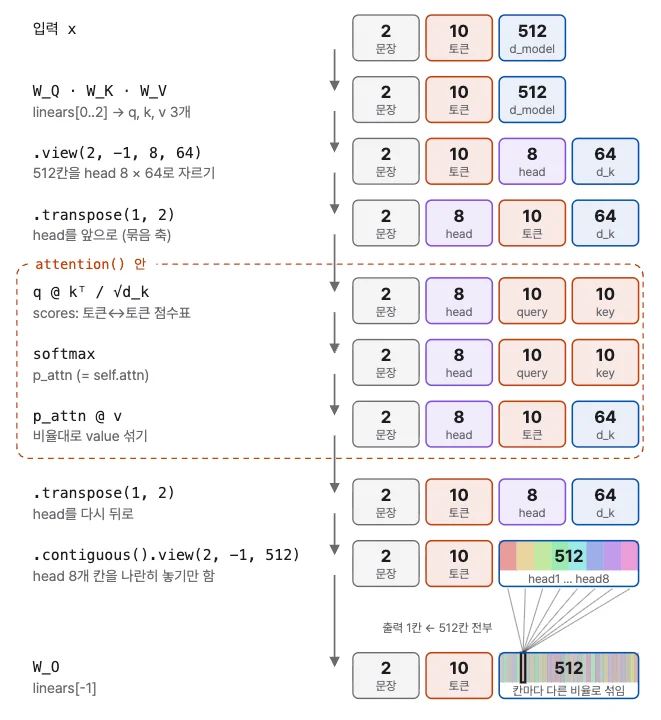
The Annotated Transformer의 MultiHeadedAttention 코드 기준 텐서 모양 변화
논문의 base 모델은 512차원을 헤드 8개 × 64차원으로 나눕니다. 헤드당 차원을 줄였기 때문에 8개를 돌려도 512차원 어텐션 하나를 돌리는 것과 계산량이 비슷하면서 동시에 여러 관점을 얻을 수 있습니다.
위치 인코딩 — 시계 바늘
어텐션은 단어끼리 내용만 비교합니다. 그래서 그 자체로는 단어가 몇 번째에 있는지 모릅니다. "나는 책을 읽는다"와 "읽는다 책을 나는"을 구분하지 못합니다. 그래서 입력 임베딩에 위치 정보를 따로 더해줍니다.
트랜스포머는 이 위치 정보를 사인과 코사인으로 만듭니다. 차원마다 주파수를 다르게 주는데, 왜 주파수가 달라야 하는지를 시계에 빗댄 설명이 잘 와닿았습니다. 시침, 분침, 초침이 각자 다른 속도로 돌기 때문에 바늘 세 개만 보고도 몇 시 몇 분 몇 초인지 알 수 있습니다. 위치 인코딩도 빠르게 도는 값과 느리게 도는 값을 함께 써서 위치를 구분합니다.
다만 이 방식에는 한계가 있습니다. 위치 값을 임베딩에 더하기 때문에 단어의 의미 값과 위치 값이 한데 섞입니다. 어텐션 점수에 "두 단어가 얼마나 관련 있나"와 상관없는 의미×위치 성분이 끼어들고, 모델은 절대 위치를 기준으로 배우게 됩니다. 3번째와 5번째 단어, 103번째와 105번째 단어는 똑같이 두 칸 떨어져 있지만 모델 입장에서는 서로 다른 경우라 따로 익혀야 합니다. 학습 때 본 적 없는 긴 문장이 들어오면 성능이 떨어집니다.
그리고 RoPE
이 한계는 이후 RoPE(Rotary Position Embedding) 로 개선됩니다. RoPE는 더하는 대신 Q와 K 벡터를 위치만큼 회전시킵니다. 그러면 두 단어를 내적했을 때 결과가 둘 사이의 거리(상대 위치) 에 따라 정해집니다.
셀프 어텐션과 크로스 어텐션
이 논문에는 두 가지 종류의 어텐션이 나옵니다. 계산 방식은 앞에서 본 수식으로 똑같고, Q와 K·V를 어디서 가져오느냐만 다릅니다.
| Q | K, V | 그림에서의 위치 | |
|---|---|---|---|
| 셀프 어텐션 | 자기 문장 | 자기 문장 | 인코더의 Multi-Head Attention, 디코더의 Masked Multi-Head Attention |
| 크로스 어텐션 | 디코더 | 인코더 | 디코더 가운데의 Multi-Head Attention (인코더에서 화살표가 들어오는 곳) |
셀프 어텐션은 한 문장 안에서 단어끼리 관계를 찾습니다. "마이클은 도서관에 갔다. 그는 책을 읽었다."를 가로세로로 놓고 어텐션 가중치를 그려보면, "마이클"과 "그는" 사이 가중치가 높게 나옵니다. 둘이 같은 사람이라는 걸 모델이 알아낸 것입니다.
크로스 어텐션은 인코더와 디코더를 잇습니다. 인코더-디코더 어텐션이라고도 하는데, 논문에서는 이 이름(encoder-decoder attention)으로 부릅니다. Q는 디코더에서, K와 V는 인코더에서 가져옵니다. 번역으로 보면 직관적입니다.
인코더 입력:  I   am   a   student     → K, V
디코더 입력:  EOS  je  suis  ...      → Q
디코더가 프랑스어 단어를 하나 만들 차례가 되면, 지금까지 만든 것을 질의로 삼아 영어 문장 어디를 봐야 할지 인코더 쪽에서 찾아옵니다.
참고로 디코더만 있는 모델(GPT 계열)에는 크로스 어텐션이 없습니다. 가져올 인코더가 없으니까요. 셀프 어텐션만 남습니다.
디코더의 Masked 어텐션
디코더의 셀프 어텐션에는 Masked가 붙어 있습니다. 디코더는 단어를 앞에서부터 하나씩 만들어야 하니, 학습할 때도 아직 나오지 않은 뒤 단어를 미리 보면 안 됩니다. 정답을 보고 정답을 맞히는 셈이 되니까요. 그래서 뒤 단어 자리의 어텐션 점수에 **−∞**를 넣어 가립니다.
          EOS    je     suis
EOS     0.8    −∞     −∞
je        0.3    0.6    −∞
suis      0.1    0.4    0.7
e^(−∞)는 0이라 소프트맥스를 거치면 가린 자리의 비중이 정확히 0이 됩니다. 각 단어는 자기 자신과 앞 단어만 보게 됩니다.
이렇게 가려두면 정답 문장을 한 번에 통째로 넣고도 모든 위치의 "다음 단어 맞히기"를 동시에 학습할 수 있습니다. RNN처럼 한 단어씩 순서대로 돌릴 필요가 없습니다.
피드포워드
어텐션 뒤에는 피드포워드 네트워크가 붙습니다.
피드포워드는 512차원을 2048차원으로 4배 넓혔다가 ReLU를 거쳐 다시 512로 줄입니다. 차원은 같아도 넓은 공간에서 비선형으로 한 번 꺾고 돌아온 값이라 원래 값과 다릅니다. 현실의 데이터는 수많은 경향이 뒤섞여 있고 그걸 그려내는 힘이 비선형 층에서 나옵니다.
어텐션은 문장 안의 다른 토큰들을 보고 필요한 정보를 가져와 각 토큰의 벡터에 섞어 넣습니다. 피드포워드는 다른 토큰을 보지 않습니다. 토큰 벡터 하나만 입력으로 받아, 그 안에 담긴 값들을 조합하고 변환합니다. 어텐션이 무엇을 가져올지를 정한다면, 피드포워드는 가져온 것으로 무엇을 만들지를 정하는 셈입니다.
| 어텐션 | 피드포워드 | |
|---|---|---|
| 하는 일 | 토큰 사이의 정보 교환 | 토큰 내부의 정보 가공 |
| 출력의 의미 | 문맥에서 가져온 정보 | 변환된 특징 |
인코더 vs 디코더
트랜스포머가 나온 직후엔 인코더만 쌓은 BERT가 더 주목받았습니다. 그런데 결국 디코더만 쌓은 GPT 계열이 크기를 키워가며 이겼습니다.
1. 구조와 목적이 단순합니다. 디코더만 쌓은 모델이 배우는 건 "다음 토큰 맞히기" 하나입니다. 그래서 인터넷에 있는 텍스트를 그대로 학습 데이터로 쓸 수 있습니다. 원래 트랜스포머처럼 인코더-디코더로 번역을 배우려면 "영어 문장 - 프랑스어 문장" 같은 짝이 필요하지만, 다음 토큰 맞히기에는 입력과 출력을 따로 나눌 필요가 없습니다. 문장 자체가 문제이자 정답입니다.
2. 스케일링이 잘 됩니다. 구조가 단순하니 크게 키우기도 쉽습니다. 더 중요한 건, 키울수록 성능이 예측 가능하게 올라갔다는 점입니다. 모델 크기, 데이터 양, 계산량을 늘리면 손실이 일정한 곡선을 따라 줄어든다는 것이 확인되면서(스케일링 법칙), "돈과 GPU를 더 넣으면 더 좋아진다"는 확신을 갖고 투자할 수 있게 됐습니다. 오픈AI가 이 방향에 크게 걸었고, 스터디에서도 "더 많은 자원을 부었을 때 진 적이 없다"는 이야기가 나왔습니다.
3. 범용성이 높습니다. 번역, 요약, 질의응답, 코딩까지 모든 작업을 "텍스트 이어 쓰기" 하나로 표현할 수 있습니다. "다음 문장을 프랑스어로 번역해줘: ..." 뒤를 이어 쓰면 번역이고, "질문: ... 답:" 뒤를 이어 쓰면 질의응답입니다. BERT는 분류든 질의응답이든 작업마다 뒤에 다른 출력층을 붙여 따로 학습시켜야 했지만, 디코더는 모델 하나로 지시만 바꾸면 됩니다. 대화형 AI에 딱 맞는 구조입니다.
4. 추론이 효율적입니다. 앞에서 본 것처럼 디코더는 마스킹 때문에 앞 토큰이 뒤 토큰을 보지 못합니다. 그래서 새 토큰이 붙어도 앞 토큰들의 K, V 값은 바뀌지 않습니다. 한 번 계산한 K, V를 저장해 두고(KV 캐시) 새 토큰 하나만 계산하면 됩니다. 긴 대화를 이어갈 때 이전 계산을 그대로 재활용할 수 있는 것입니다. 반면 양방향으로 보는 인코더는 토큰 하나가 추가되면 앞 토큰들의 표현까지 전부 달라지니 처음부터 다시 계산해야 합니다.
마무리
4장 내내 "정보를 잃지 않고 끝까지 전달하려면 어떻게 해야 할까"를 고민했다면, 5장은 "순서대로 전달하지 말고 처음부터 다 보면 되지 않나" 로 답합니다. 그 결과 RNN의 순환이 사라졌고 대신 순서를 알려주는 장치인 위치 인코딩이 필요해졌습니다.
트랜스포머 모델은 이전에 배웠던 내용보다 난이도가 높았습니다. 그래도 각자 막힌 부분을 꺼내놓고 이해한 내용을 서로 공유하며 토론하고 맞춰나갔습니다. 다음 시간에도 트랜스포머 이야기를 이어서 해볼 예정입니다.
참여해주신 분들 모두 고생 많으셨습니다. 어느새 다음주가 이번 스터디의 마지막 시간입니다. 다음 시간에 뵙겠습니다.