[Review] 박종훈의 AI 논문 스터디 - 6주차 후기 (어텐션의 다른 갈래들)
안녕하세요! K-DEVCON 그로스 매니저 박종훈입니다.
AI 논문 스터디 여섯 번째 시간이 10월 19일(월)에 있었습니다. 지난 시간에 트랜스포머를 읽었고 이번에는 5장의 나머지 부분을 봤습니다. 트랜스포머보다 먼저 나와서 어텐션을 다른 방식으로 써본 논문들입니다.
- Pointer Networks (2015) — 어텐션 가중치를 그대로 답으로 쓴다
- Neural Turing Machines (2014) — 신경망에 읽고 쓰는 외부 메모리를 붙인다
- Order Matters: Sequence to Sequence for Sets (2015) — 순서가 없는 데이터도 넣는 순서에 따라 결과가 달라진다
솔직히 이번 범위는 다들 조금 아쉬워했습니다. 첫 이야기부터 "차라리 이걸 먼저 읽고 이번 주에 트랜스포머를 했으면 좋았겠다"였습니다. 트랜스포머를 이미 알고 나니 "얘네는 왜 이제 와서 나오지?" 싶은 생각이 들었습니다. 그래도 이야기를 나누다 보니 트랜스포머에 이르기 전에 어떤 시도들이 있었는지는 꽤 선명하게 보였습니다.
왜 자꾸 "미분 가능한"이라고 할까
이번 범위의 논문들을 읽다 보면 "미분 가능한(differentiable)" 이라는 말이 계속 나옵니다. 미분 가능한 메모리 접근, 미분 가능한 주소 지정 같은 식입니다.
처음에는 "그래서 뭐가 미분 가능하다는 거지?", "미분이 되면 뭐가 좋은 거지?"라는 생각이 들었습니다.
결국 미분하려는 대상은 손실 함수였습니다. 손실 함수를 미분하면 기울기를 얻을 수 있고, 신경망은 이 기울기를 보고 가중치를 "왼쪽으로 조금, 오른쪽으로 조금" 옮기면서 최저점을 찾아갑니다. 미분이 되어야 학습을 할 수 있는 것입니다. 그런데 이 기울기는 손실에서 출발해 신경망의 연산을 하나씩 거꾸로 거치며 가중치까지 전달됩니다. 그래서 중간에 미분이 안 되는 연산이 하나라도 끼어 있으면 그 앞쪽으로는 기울기가 끊겨 학습이 되지 않습니다. 논문에서 말하는 "미분 가능한 메모리 접근"은 메모리를 읽는 연산도 이 흐름을 끊지 않아야 한다는 뜻입니다.
손실 함수 이야기는 이전부터 계속 나왔습니다. 그런데 이번 장에서는 왜 유독 "미분 가능한"이 강조될까요? 지금까지는 행렬 곱이나 ReLU처럼 원래 미분이 되는 연산만 썼는데, 이번에는 미분이 안 되는 연산이 끼어들었기 때문입니다.
이번 주차의 논문들이 하고 싶은 일은 하나같이 "여러 개 중 하나를 고르는 것" 입니다. 입력 중 하나를 가리키거나, 메모리의 한 칸을 읽는 식이죠. 문제는 하나를 딱 고르는 연산(argmax, 정수 인덱스)으로는 쓸모 있는 기울기를 얻을 수 없다는 점입니다.
신경망 출력: 2.7        → round → 인덱스 3 → memory[3]
신경망 출력: 2.71       → round → 인덱스 3 → memory[3]   (값이 조금 바뀌어도 결과가 그대로)
출력을 조금 움직여도 결과가 전혀 변하지 않습니다. 기울기가 0이라는 뜻이고, 그러면 어느 방향으로 고쳐야 할지 알 수 없어 그 앞쪽 가중치는 학습되지 않습니다.
해법은 지난주에 본 어텐션이었습니다. 하나를 고르지 않고 모든 후보에 확률을 나눠 준 뒤 그 비율대로 섞습니다. 소프트맥스와 가중합은 매끄러운 연산이라 미분이 됩니다. 학습이 잘 되면 확률이 한 곳에 몰려서 결과적으로는 "하나를 고른 것"과 비슷해집니다.
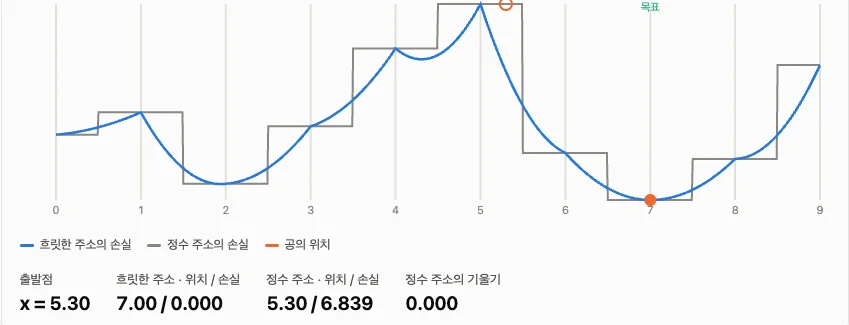
정수 주소(하나만 고르기, 회색)와 흐릿한 주소(확률로 나눠 읽기, 파랑)의 손실. 같은 곳에서 출발해 경사 하강을 돌리면 흐릿한 주소만 목표(7)까지 내려갑니다. 출처: How NTM Works 데모 7
이번 논문들은 이 아이디어를 각자 다른 곳에 썼습니다.
Pointer Networks (2015)
seq2seq가 풀지 못하는 문제
평면 위에 점 몇 개가 있을 때, 바깥쪽 점들을 이어 모든 점을 감싸는 다각형을 찾는 볼록 껍질(Convex Hull) 문제를 생각해 보겠습니다.
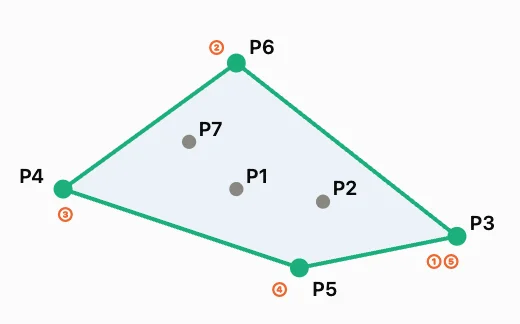
입력: P1~P7 / 출력: P3 → P6 → P4 → P5 → P3 (주황 숫자가 출력 순서). 출처: How Pointer Network Works
답은 입력 중 몇 번째 점인지의 나열입니다. 그런데 seq2seq는 출력할 수 있는 단어 사전이 미리 정해져 있습니다. 점 5개짜리 문제로 학습해 사전을 {1, ..., 5}로 만들었다면, 위처럼 점이 7개인 문제에서는 "6번"을 말할 수 없습니다. 출력 사전의 크기가 입력 길이에 따라 바뀌어야 하는 문제를 기존 구조로는 다룰 수 없었습니다.
어텐션 가중치 자체를 답으로
Pointer Network의 해법은 간단합니다. Bahdanau 어텐션과 계산은 같고, 마지막에 그 결과를 어떻게 쓰느냐만 다릅니다.
| Bahdanau 어텐션 | Pointer Network | |
|---|---|---|
| 입력 위치별 점수 계산 | 디코더 상태와 인코더 상태로 점수 → 소프트맥스 | 같음 |
| 그 확률을 어디에 쓰나 | 인코더 상태들의 가중 평균(문맥 벡터)을 만든다 | 그 확률을 그대로 출력으로 쓴다 |
| 최종 출력 | 문맥 벡터 → 출력층 → 고정된 단어 사전에서 선택 | 입력 중 한 위치를 가리킨다(pointer) |
한마디로 Pointer Network에서는 그 확률 자체가 답입니다.
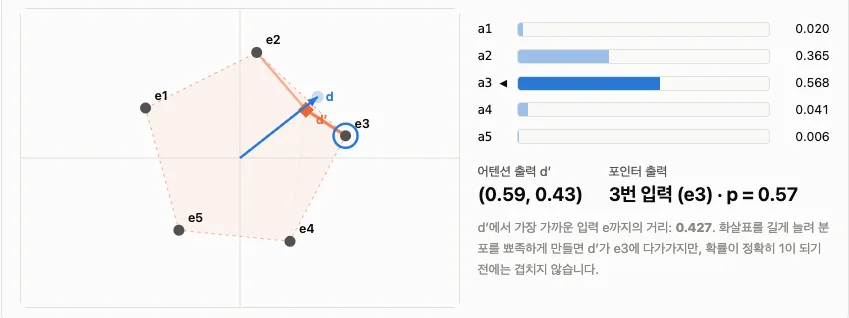
확률로 섞으면(어텐션) 결과 d′는 입력들 사이 어딘가에 놓이고, 가리키면(포인터) 반드시 입력 중 하나(e3)가 답이 됩니다. 출처: How Pointer Network Works 데모 3
이렇게 하면 출력 후보가 곧 입력이라, 입력이 7개면 7개 중에서, 50개면 50개 중에서 고릅니다. 입력에는 있는데 출력 사전에는 없어서 엉뚱한 답이 나오는 문제도 사라집니다.
논문은 이 방식으로 볼록 껍질, 들로네 삼각분할, 외판원 문제(TSP) 같은 기하·조합 문제를 풀었습니다. 모두 "입력 점들의 번호를 골라 나열하는" 문제입니다. 그래서 "이런 시나리오가 아니면 쓰기 어렵겠다"는 반응도 나왔습니다. 당시에는 딥러닝으로 이것저것 시도하던 시기였고 Pointer Network도 그 흐름에 있는 초창기 논문이었습니다.
Neural Turing Machines (2014)
신경망에 메모리를 붙이자
RNN과 LSTM은 기억을 히든 스테이트 안에 담습니다. 더 많이 기억하게 하려면 히든 크기를 키워야 하는데, 그러면 파라미터 수가 제곱으로 늘어납니다. 어디에 무엇이 들어 있는지도 알 수 없는 블랙박스입니다. NTM은 여기에 컴퓨터처럼 읽고 쓸 수 있는 외부 메모리를 붙이자고 제안합니다. 메모리 칸을 늘려도 신경망의 파라미터 수는 그대로입니다.
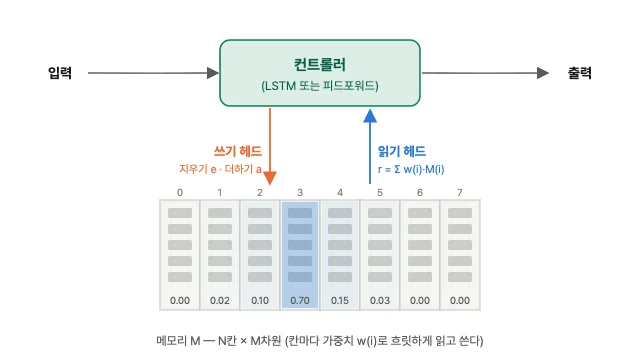
NTM의 구조. 헤드는 한 칸만 집지 않고 칸마다 가중치를 나눠 읽고 씁니다.
컨트롤러는 매 스텝 "메모리의 어디를 읽고 어디에 쓸지"를 정합니다. 튜링 머신이 테이프 위에서 헤드를 움직이며 읽고 쓰는 것처럼, NTM은 메모리 위에서 읽기·쓰기 헤드를 움직입니다. 이름도 여기서 왔습니다.
여기서도 앞의 문제가 그대로 나옵니다. "3번 칸을 읽어라"처럼 칸을 딱 집으면 미분이 안 됩니다. 그래서 NTM은 모든 칸에 가중치를 나눠 주고, 그 비율대로 읽고 씁니다.
읽기: r = Σ w(i) · M(i)                         (칸별 가중치로 섞어 읽기)
쓰기: M(i) ← M(i) · (1 − w(i)·e) + w(i)·a        (지울 만큼 지우고, 더할 만큼 더하기)
주소를 정하는 두 가지 방법
어느 칸에 가중치를 몰아줄지 정하는 방법이 두 가지 나옵니다. 스터디에서 시간을 가장 많이 쓴 부분입니다.
Content-based addressing 은 내용이 비슷한 칸을 찾습니다. 컨트롤러가 찾고 싶은 내용을 벡터(key)로 내놓으면, 메모리의 모든 칸과 유사도를 구하고 소프트맥스로 가중치를 만듭니다. 지난주에 본 어텐션의 Q와 K 비교와 거의 같아서 다들 바로 이해했습니다.
Location-based addressing 은 이해하기 어렵다는 이야기가 여러 번 나왔습니다. 정리하면 "방금 본 칸에서 몇 칸 옆으로 옮겨라" 입니다.
- 보간(interpolation): 출발점을 정합니다. 이번에 내용으로 찾은 칸에서 새로 시작할지, 직전 스텝의 칸에서 이어 갈지를 게이트 g가 고릅니다. g가 1이면 새로 찾은 칸, 0이면 직전 칸이고, 그 사이 값이면 둘을 섞습니다.
- 이동(shift): 그 가중치를 −1, 0, +1칸 같은 범위에서 옆으로 밉니다. 얼마나 밀지도 컨트롤러가 확률로 내놓습니다. 그래서 한 칸에 딱 옮겨지지 않고 확률만큼 나뉘어 조금 번집니다.
- 날카롭게(sharpening): 밀면서 퍼진 가중치를 다시 한 곳으로 모읍니다. 이 단계가 없으면 이동할 때마다 번짐이 쌓여서, 몇 스텝만 지나도 초점이 메모리 전체로 퍼져 지금 어디를 보고 있는지 알 수 없게 됩니다.
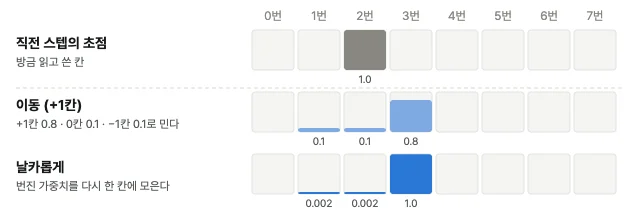
직전 초점(2번)에서 이어 가기로 한 뒤의 흐름. 순서대로 복사할 때처럼 2번에서 한 칸 옆으로 밀고(이동), 번진 가중치를 3번 한 칸에 다시 모읍니다(날카롭게).
논문은 이런 메모리로 복사, 반복 복사, 정렬 같은 단순한 작업을 해 보면서, 어텐션으로 컴퓨터처럼 메모리를 읽고 쓰는 일까지 할 수 있는지 시험했습니다.
트랜스포머와의 비교
어텐션으로 메모리를 다룬다는 출발점은 같지만 방향이 갈립니다.
| NTM | 트랜스포머 | |
|---|---|---|
| 메모리 | 고정된 N칸 | 토큰마다 K·V가 쌓인다 (KV 캐시) |
| 쓰기 방식 | 기존 칸을 덮어쓴다 | 뒤에 추가만 한다 |
| 주소 지정 | 내용 + 위치(이동) | 내용(Q·K 비교)만 |
| 학습 | 어디에 쓸지까지 배워야 해서 매우 까다로움 | 단순해서 크게 키우기 쉬움 |
NTM은 메모리가 고정돼 있으니 아끼려고 덮어쓰는 구조를 택했고 그 대가로 학습이 아주 어려워졌습니다. 트랜스포머는 메모리 걱정을 접고 일단 다 쌓아 둡니다. 결과적으로 크기를 키웠을 때 이긴 쪽은 단순한 쪽이었습니다. 지난주 "왜 디코더만 쌓은 모델이 이겼나"에서 나온 이야기와도 닿아 있습니다.
Order Matters: Sequence to Sequence for Sets (2015)
"이 논문은 순서가 중요하다는 거야, 중요하지 않다는 거야?" 이번 논문은 이 질문으로 시작했습니다. 읽어 보면 답은 "원래는 중요하지 않아야 하는데, 실제로는 중요했다" 입니다.
입력 쪽 — 집합인데 순서가 결과를 바꾼다
숫자 다섯 개를 정렬하는 문제를 생각해 보겠습니다. {5, 2, 9, 1, 7}과 {9, 1, 7, 5, 2}는 같은 집합이니 답도 같아야 합니다. 그런데 seq2seq는 입력을 앞에서부터 순서대로 읽으니, 넣는 순서에 따라 결과가 달라질 수 있습니다. 실제로 그랬습니다. 번역에서 입력 문장을 거꾸로 넣으면 BLEU가 5점 올랐고, 볼록 껍질 문제에서 점을 각도순으로 정렬해 넣으면 정확도가 최대 10%p 올랐습니다.
그래서 논문은 입력을 순서대로 읽지 않는 Read-Process-Write 구조를 제안합니다. 원소들을 각각 메모리에 넣어 두고 어텐션으로 여러 번 훑어 집합 전체의 표현을 만드는 방식입니다. 어텐션은 순서 없이 모든 원소를 한꺼번에 보니 입력 순서에 흔들리지 않습니다.
출력 쪽 — 어떤 순서로 내놓는 게 정답인가
출력이 집합인 경우는 더 까다롭습니다. 정답이 {A, B, C}라면 A→B→C로 내든 C→A→B로 내든 다 맞습니다. 그런데 모델에게는 어떤 순서로 배우느냐가 성능을 바꿉니다. 예를 들어 구문 트리를 깊이 우선으로 펼쳐 출력하면 성능이 89.5%였지만, 너비 우선으로 펼치면 81.5%로 떨어졌습니다.
논문의 해법은 처음에는 모든 순서를 열어 두고, 학습하면서 모델이 가장 편해하는 순서를 정답으로 삼자는 것입니다. 초반에는 여러 순서를 골고루 보여주다가, 어느 정도 학습이 되면 모델이 가장 높은 확률을 주는 순서에 무게를 실어 줍니다. 언제 넘어갈지는 하이퍼파라미터입니다.
요즘도 이런 설정이 의미가 있을까
"현대 모델 학습에서도 이런 하이퍼파라미터가 중요한가요?"라는 질문이 이어졌습니다.
요즘은 그보다 사람의 피드백이 훨씬 중요하다는 이야기가 나왔습니다. ChatGPT가 가끔 "두 답변 중 어느 쪽이 더 좋은가요?"라고 묻는 게 바로 그 데이터입니다. 사람이 고른 답에 보상을 주는 강화학습, 즉 RLHF(Reinforcement Learning from Human Feedback) 입니다.
러닝 레이트나 에포크 같은 하이퍼파라미터는 한정된 데이터로 최저점에 가는 경로를 찾는 장치입니다. 데이터가 충분히 많으면 결국 어딘가로 수렴하고, 그다음부터는 "이 출력이 정말 좋은 출력인가"를 알려주는 신호가 성능을 가른다는 이야기였습니다.
그 외에 나온 이야기들
inference와 reasoning
보통 스터디를 시작하며 이런저런 이야기를 나누는 편입니다. 오늘은 추론 모델 이야기가 나왔고 자연스럽게 "지난주에 배운 트랜스포머는 추론 모델인가, 아닌가?"라는 질문으로 이어졌습니다.
누군가는 추론 모델이라고 하고 누군가는 아니라고 했는데, 알고 보니 추론이라는 말을 서로 다르게 이해하고 있었기 때문이었습니다.
추론에는 두 가지 뜻이 있습니다. 한국어로는 둘 다 추론이지만 영어로는 inference와 reasoning으로 나뉩니다.
| Inference | Reasoning | |
|---|---|---|
| 뜻 | 학습이 끝난 모델로 결과를 뽑는 것 | 답을 내기 전에 여러 단계를 거쳐 생각하는 것 |
| 하는 일 | forward만 한다 (backward와 가중치 갱신 없음) | 중간 생각을 토큰으로 길게 생성한 뒤 답을 낸다 |
| 해당하는 모델 | 지금까지 배운 모든 모델 | o1, Claude의 extended thinking 같은 최근 LLM |
트랜스포머가 추론 모델이라고 한 쪽은 inference를, 아니라고 한 쪽은 reasoning을 떠올린 것입니다. LLM이 나오고 나서야 "이 모델은 추론(reasoning)이 되나?"라는 말을 쓰기 시작했으니, 트랜스포머 논문에 그런 이야기가 없는 게 당연합니다. 책 뒷부분에서 다룬다고 합니다.
KV 캐시와 RAG
이야기하다 보니 KV 캐시와 RAG가 어떻게 다른지도 짚게 됐습니다.
- RAG: 모델 바깥에서 관련 문서를 찾아 입력(프롬프트)에 붙여 넣습니다.
- KV 캐시: 모델 안쪽의 이야기입니다. 지난주에 봤듯 디코더는 앞 토큰의 K·V가 바뀌지 않으니, 저장해 두고 새 토큰을 만들 때 다시 계산하지 않습니다.
여기서 한 가지 헷갈리기 쉬운 게 있습니다. 같은 문서를 여러 요청에 반복해서 보낼 때 앞부분 계산을 재활용하는 기능은 프롬프트 캐싱입니다. 원리는 KV 캐시와 같지만, "비슷한" 입력이 아니라 앞부분이 정확히 같은 입력일 때만 적용됩니다.
RAG는 아직 필요한가
이번 시간에 가장 길게 이어진 이야기입니다. 요즘은 Claude Code나 Codex가 필요한 자료를 알아서 찾아오니 굳이 RAG를 따로 구축해야 하나 하는 의견이 많았습니다. CLAUDE.md에 문서를 적어 두거나, MCP로 GitHub·Jira·Confluence를 연결하면 대부분 해결된다는 거죠.
- 임베딩 검색이 생각보다 잘 안 된다는 경험이 여럿 나왔습니다. 원하는 문서를 잘 못 끌어와서 차라리 전통적인 키워드 검색이 낫더라는 겁니다.
- 운영이 번거롭습니다. 사내 위키를 RAG에 올려 두면 문서가 바뀔 때마다 배치로 다시 넣어야 합니다. 결국 검색 엔진에 데이터를 넣고 갱신하는 일과 다르지 않습니다.
- 반대로 실시간성이나 속도가 중요하면 여전히 강점이 있고, 결과가 나쁜 건 데이터가 부족하거나 저장 방식이 맞지 않아서일 수 있다는 의견도 있었습니다.
- 지식 그래프(대한민국 —수도→ 서울 같은 관계 데이터)가 있어야 RAG가 제대로 의미가 있다는 의견도 나왔습니다. 공공기관처럼 정형화된 데이터가 많은 곳에서는 유용하겠지만, 일반 기업에서는 검색 API를 잘 만드는 편이 낫다는 쪽으로 이야기가 모였습니다.
"좋다고는 하는데, 좋게 쓰기가 너무 어렵다."로 정리됐습니다.
마무리
Pointer Network는 어텐션 가중치를 답으로 썼고, NTM은 어텐션으로 메모리를 읽고 썼고, Order Matters는 어텐션으로 순서의 굴레에서 벗어나려 했습니다. 트랜스포머는 이 갈래들 중에서 가장 단순한 길, "다 쌓아 두고 내용으로만 찾는다"를 골랐고 그게 가장 크게 자랐습니다.
이번 시간으로 5장까지 마쳤습니다. AlexNet에서 시작해 RNN과 LSTM을 지나 트랜스포머까지 6주 동안 달려왔습니다. 솔직히 혼자였다면 시작조차 제대로 못 했을 것 같습니다. 막히는 부분이 나올 때마다 각자 찾아본 내용을 꺼내놓고 함께 붙잡고 있다 보니 여기까지 올 수 있었습니다. 함께해 주신 스터디원분들께 감사드립니다.
2기에서는 남은 6장부터 9장을 같은 방식으로 이어갑니다. 이제부터는 지금 쓰고 있는 LLM에 훨씬 가까운 내용이라 더 재미있을 것 같습니다. AI 논문을 함께 읽고 싶은 분들의 많은 관심을 부탁드립니다.
📝 모집 공고: https://k-devcon.com/channel/6/post/727
참여해주신 분들 모두 고생 많으셨습니다. 2기에서 다시 뵙겠습니다.