[Review] 박종훈의 AI 논문 스터디 2기 - 1주차 후기 (스케일링 법칙과 병렬화)
안녕하세요! K-DEVCON 그로스 매니저 박종훈입니다.
AI 논문 스터디 2기 첫 시간이 11월 9일(월)에 있었습니다.
(1기 6주차 후기 보러가기)
1기에서 5장 트랜스포머까지 읽었고 2기에서는 6장부터 9장까지 이어서 읽습니다.
이번에 읽은 6장의 제목은 The birth of hyperscale입니다. 크게 두 덩어리로 나뉩니다.
- 스케일링 법칙 — 모델을 얼마나, 어떤 비율로 키워야 하는가 (Kaplan → Chinchilla → post-Chinchilla)
- 병렬화 — 그렇게 커진 모델을 실제로 어떻게 학습시키는가 (GPipe, Megatron-LM, ZeRO)
1. 스케일링 법칙 — Kaplan → Chinchilla → post-Chinchilla
스케일링 법칙은 "모델을 얼마나, 어떤 비율로 키워야 하는가"에 대한 답인데 큰 흐름을 한 줄씩 정리하면 이렇습니다.
| 한 줄 요약 | 토큰 : 파라미터 | |
|---|---|---|
| Kaplan (2020) | 모델을 키워라 | GPT-3 약 1.7 : 1 |
| Chinchilla (2022) | 모델과 데이터를 균형 있게 키워라 | 약 20 : 1 |
| post-Chinchilla | 작게 만들고 오래 학습시켜라 | Llama 3 8B 약 1,875 : 1 |
Kaplan부터 하나씩 짚어 보겠습니다.
공통의 틀 — 로그-로그 평면의 직선
스케일링 법칙의 핵심은 멱법칙(power law) 입니다. 한 양이 다른 양의 거듭제곱에 비례하는 관계(y = k · x^α)로, 양쪽에 로그를 씌우면 직선이 됩니다. 모델의 loss를 파라미터 수에 대해 로그-로그 그래프로 그리면 놀라울 만큼 곧은 직선이 나옵니다.
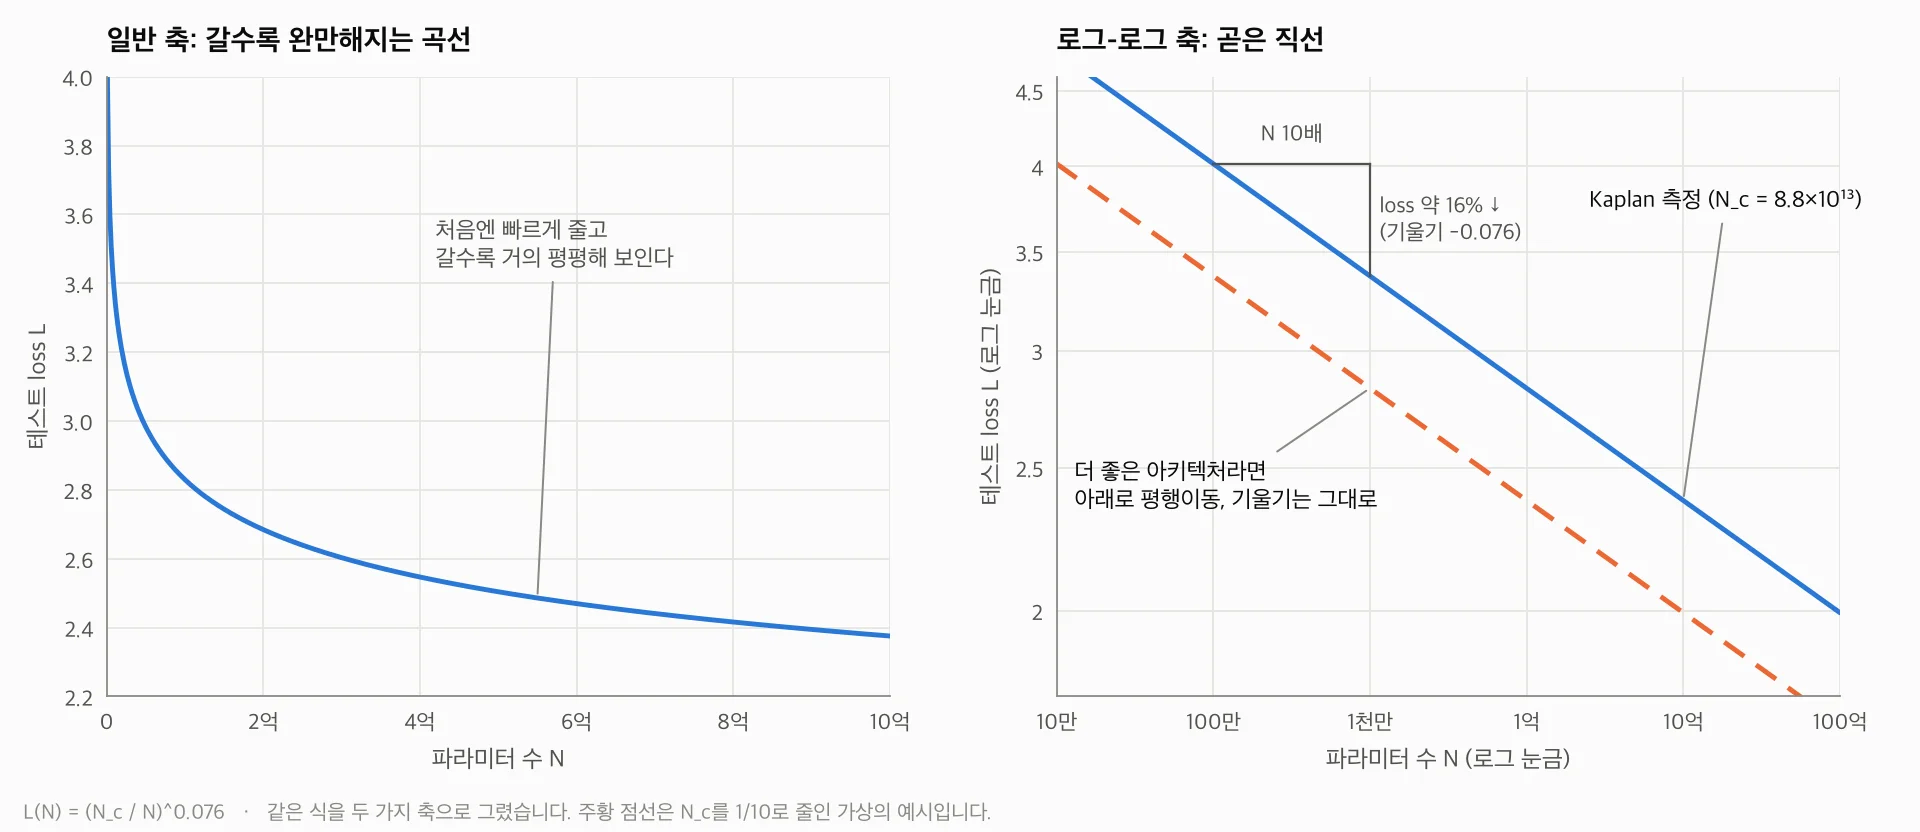
같은 식을 두 가지 축으로 그렸습니다. 일반 축에서 "갈수록 효과가 없어 보이는" 곡선이 로그-로그 축에서는 곧은 직선이 됩니다. 주황 점선은 아키텍처가 좋아져 N_c가 1/10로 줄었다고 가정한 예시로, 기울기는 그대로이고 아래로 평행이동만 합니다.
L(N) = (N_c / N)^α_N
log L = −α_N · log N + α_N · log N_c       (기울기 −α_N인 직선)
- L: 테스트 데이터에서 잰 크로스엔트로피 loss (nats/토큰)
- N: 임베딩을 뺀 파라미터 수. 임베딩까지 세면 깊이와 너비에 따라 곡선이 들쭉날쭉해지는데 빼고 세면 깔끔한 직선이 됩니다.
- α_N ≈ 0.076: 파라미터를 10배 늘리면 loss가 10^(−0.076) ≈ 0.84배, 약 16% 줄어듭니다.
- N_c ≈ 8.8×10¹³: 직선의 위치를 정하는 상수입니다.
이 연구 이전에 Baidu의 Hestness 등(2017)이 먼저 짚은 게 있습니다. 좋은 아키텍처는 이 직선을 아래로 평행이동시킬 뿐, 기울기는 바꾸지 못한다는 것입니다. 그렇다면 그다음부터 성능을 올리는 건 아이디어가 아니라 예산 문제가 됩니다. 이 때문에 업계는 새로운 구조를 찾는 대신 모델을 키우는 쪽으로 방향을 틀었습니다.
Kaplan (2020) — 모델을 키워라
Kaplan 등(2020, OpenAI)은 이 관계를 트랜스포머 언어 모델에서 꼼꼼하게 측정했습니다. Kaplan은 지금 Anthropic의 공동 창업자이기도 합니다.
| 조작 | loss 감소 | 지수 |
|---|---|---|
| 파라미터 수 N 2배 | 약 5% | α_N ≈ 0.076 |
| 학습 데이터 D 2배 | 약 6% | α_D ≈ 0.095 |
데이터는 모델 크기만큼 늘릴 필요가 없습니다. D ∝ N^0.74, 즉 모델을 2배 키우면 데이터는 약 1.7배, GPT-2(15억)에서 GPT-3(1,750억)로 파라미터를 117배 키우면 데이터는 약 34배만 늘리면 됩니다.
그리고 이 논문의 가장 유명한 결론이 나옵니다. 연산 예산이 정해져 있으면 작은 모델을 끝까지 학습시키는 것보다 큰 모델을 짧게 학습시키는 쪽이 낫다. 큰 모델은 같은 토큰에서 더 많이 배우기 때문입니다(표본 효율).
Kaplan은 무엇을 놓쳤나
Kaplan의 결론 하나가 뒤집힌 데는 실험 방식의 문제가 있었습니다. 바로 학습률 스케줄입니다. 스케줄은 학습하는 동안 학습률을 언제 얼마로 바꿀지 미리 정해 둔 규칙입니다.
Kaplan은 "큰 모델을 학습시키다가 수렴하기 훨씬 전에 멈추는 게 효율적"이라고 보고 긴 학습의 중간 지점을 "일찍 멈춘 모델"로 간주했습니다. 그런데 일찍 멈출 계획이었다면 스케줄도 그 길이에 맞춰 줄였어야 합니다. 스케줄을 100으로 잡아 두고 30에서 멈추면 학습률이 아직 충분히 내려가지 않은 상태라 성능이 실제보다 나쁘게 나옵니다. 측정 방식 자체가 "짧게 학습하면 손해"라는 쪽으로, 즉 스스로의 결론을 강화하는 방향으로 치우쳐 있었습니다. Chinchilla 논문이 바로 이 지점을 짚었습니다.
Chinchilla (2022) — 모델과 데이터를 균형 있게
DeepMind의 Chinchilla(2022)는 400개 넘는 모델을 학습시켜 파라미터당 약 20토큰이 최적이라는 결과를 냈습니다. 이 기준으로 보면 1,750억 파라미터를 3,000억 토큰으로 학습한 GPT-3는 파라미터당 1.7토큰으로, 데이터를 크게 굶은 모델이었습니다.
그렇다고 Kaplan이 틀렸다고만 보기는 어렵습니다. 실험한 데이터 규모가 달라지니 결론도 달라진 것에 가깝습니다. Kaplan의 실험은 230억 토큰까지였고 그 범위 안에서는 모델을 키우는 쪽이 가장 효과가 컸습니다. Chinchilla가 5,000억 토큰까지 넓혀 보니 데이터를 늘렸을 때의 효과가 Kaplan의 범위에서 보이던 것보다 훨씬 오래 이어졌고, 무게도 데이터 쪽으로 옮겨 갔습니다.
post-Chinchilla — 작게, 오래, 그리고 추론 시점에도
post-Chinchilla의 방향을 한 줄로 줄이면 "작게, 오래, 그리고 추론 시점에도 스케일링하라" 입니다. 비유하자면 평범한 학생을 아주 오래 공부시키고, 어려운 문제를 만나면 충분히 고민할 시간을 주는 쪽입니다.
- 작게: 파라미터 수는 오히려 줄입니다.
- 오래: 대신 Chinchilla의 20토큰을 훌쩍 넘겨 파라미터당 수백~수천 토큰을 학습시킵니다. Llama 3 8B는 15조 토큰, 파라미터당 약 1,875토큰을 학습했습니다.
- 추론 시점에도: 학습이 끝난 뒤에도 어려운 문제에서는 답하기 전에 더 오래 생각하게 해서 성능을 끌어올립니다. 다음 7장에서 다룰 추론(reasoning) 모델로 이어지는 흐름입니다.
여기서 헷갈리기 쉬운 부분이 있습니다. Chinchilla도 데이터를 늘리라고 했고 post-Chinchilla도 데이터를 늘리는데, 뭐가 다를까요?
- Chinchilla가 데이터를 늘린 건 학습 효율이 그게 더 좋아서입니다. "데이터 쪽으로 가되 파라미터당 20토큰에서 멈춰라, 그게 학습 효율의 최적점이다."
- post-Chinchilla는 학습 효율을 일부 손해 보면서까지 데이터를 늘립니다. 이유는 추론 비용입니다. 모델이 크면 추론을 할 때마다 그만큼 비용이 듭니다. 학습 비용은 한 번 치르면 끝나지만 추론 비용은 모델을 서비스하는 내내 쌓입니다. 그러니 모델을 작게 만들어 추론에 드는 비용을 낮추는 대신 데이터를 수백~수천 토큰/파라미터까지 부어서 성능을 메웁니다.
Chinchilla의 키워드가 균형이라면 post-Chinchilla의 키워드는 운영입니다. 연구실에서 가장 좋은 모델을 만드는 관점보다는 만든 모델을 실제 서비스로 운영하는 쪽의 관점에 가깝습니다.
2. 데이터는 무한하지 않다
모델 크기에서 데이터로 무게가 옮겨 가면 결국 데이터가 모자라게 됩니다. 이 이야기로 자연스럽게 넘어갔습니다.
테스트셋 오염
인터넷을 긁어서 학습 데이터를 만들다 보면 모델을 평가할 테스트셋이 학습 데이터에 섞여 들어갑니다. SQuAD나 GLUE 같은 벤치마크는 GitHub과 튜토리얼 곳곳에 퍼져 있으니 피하기가 어렵습니다. 더 어려운 벤치마크를 계속 새로 만들어도 많이 쓰이는 순간 같은 처지가 됩니다.
우리도 LLM을 만들어 볼 수 있을까
LLM을 직접 만들어 보려면 데이터부터 있어야 합니다. 그런데 프론티어 모델들은 학습 데이터를 공개하지 않습니다.
| 데이터셋 | 내용 |
|---|---|
| WebText (GPT-2) | Reddit에서 추천(karma)을 3개 이상 받은 글에 걸린 외부 링크를 모은 데이터 |
| WebText2 (Kaplan, GPT-3) | 같은 방식으로 더 오래 수집. 약 230억 토큰 |
| OpenWebText / OpenWebText2 | WebText를 공개 재현한 데이터셋 |
| Common Pile v0.1 | 공개 라이선스 텍스트를 모은 약 8TB 데이터셋 |
WebText와 WebText2는 다운로드할 수 없습니다. 직접 만들어 보려면 재현 데이터셋을 쓰거나 같은 방식으로 직접 모아야 합니다.
낙타는 사막에 있다
데이터에는 spurious pattern이라는 함정도 있습니다. 낙타 사진은 늘 사막에, 소 사진은 늘 풀밭에 있다면 모델은 낙타 대신 사막을 학습할 수 있습니다. 상관관계가 있을 뿐인데 그걸 지름길로 삼아 버리는 겁니다.
큰 모델일수록 대상과 배경을 더 잘 분리해 낸다는 연구가 있습니다. 반면 책 6.2절은 반대 방향도 다룹니다. 어떤 과제에서는 큰 모델이 이런 가짜 패턴에 더 확신을 갖고 매달렸다가 규모를 더 키우거나 데이터가 나아진 뒤에야 회복합니다(inverse scaling). 두 이야기가 어떤 조건에서 갈리는지는 따로 찾아볼 거리로 남겼습니다.
3. 병렬화 — 한 장치에 모델이 다 들어가지 않는다
스케일링 법칙이 "키우면 된다"고 말해도 실제로 키우는 건 다른 문제입니다. 모델이 GPU 한 장에 들어가지 않기 때문입니다.
출발점 — 데이터 병렬(DP)
가장 단순한 방법은 GPU마다 모델을 통째로 복사하고 배치만 나누는 것입니다. 각자 forward와 backward를 한 뒤 기울기를 서로 주고받아 평균을 내고(all-reduce), 모두가 똑같이 갱신합니다.
문제는 메모리입니다. 혼합 정밀도로 Adam을 쓰면 파라미터 하나에 16바이트(가중치 2 + 기울기 2 + 옵티마이저 상태 12)가 듭니다. GPU마다 이걸 통째로 들고 있어야 해서 모델이 커지면 금방 한계에 닿습니다.
참고로 AlexNet도 이미 GPU 두 장에 모델을 나눠 실었습니다. 책은 이걸 "손으로 한 텐서 샤딩"이라고 부릅니다. 그때는 아키텍처를 GPU 두 장에 맞춰 직접 쪼갰다면 이후의 연구들은 이걸 훨씬 확장 가능한 형태로 일반화했습니다.
GPipe — CPU 파이프라인을 닮은 구조
GPipe는 컴퓨터 구조의 명령어 파이프라인과 같은 발상입니다. CPU는 명령어를 가져오고(fetch), 해석하고(decode), 실행하는(execute) 단계를 하나씩 끝내고 넘어가지 않습니다. 단계를 겹쳐서 돌립니다. 컨베이어 벨트처럼 처리량을 늘리는 방식입니다. (https://en.wikipedia.org/wiki/Instruction_pipelining)
모델이 한 장치에 안 들어가면 가장 먼저 떠오르는 방법은 층을 잘라 장치마다 나눠 싣는 것입니다. 그런데 배치를 통째로 흘리면 앞 장치가 계산하는 동안 뒤 장치는 기다리고, 역전파가 돌아올 때는 반대로 앞 장치가 기다립니다. 장치 4대면 늘 한 대만 일하고 나머지 75%는 놉니다.
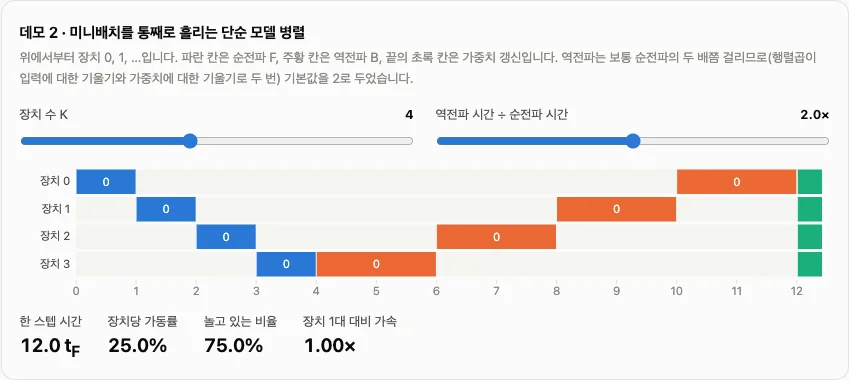
층만 나누고 배치는 통째로 흘린 단순 모델 병렬. 어느 순간에나 한 장치만 일합니다. 출처: How GPipe Works 데모 2
GPipe는 층 묶음(스테이지)을 장치마다 나눠 싣고, 미니배치를 마이크로배치로 쪼개서 흘려보냅니다. 장치 0이 첫 번째 조각을 넘기고 나면 바로 두 번째 조각을 받습니다. 기울기는 마이크로배치마다 모아 두었다가 배치가 끝날 때 한 번에 갱신하므로 결과는 쪼개지 않았을 때와 같습니다.
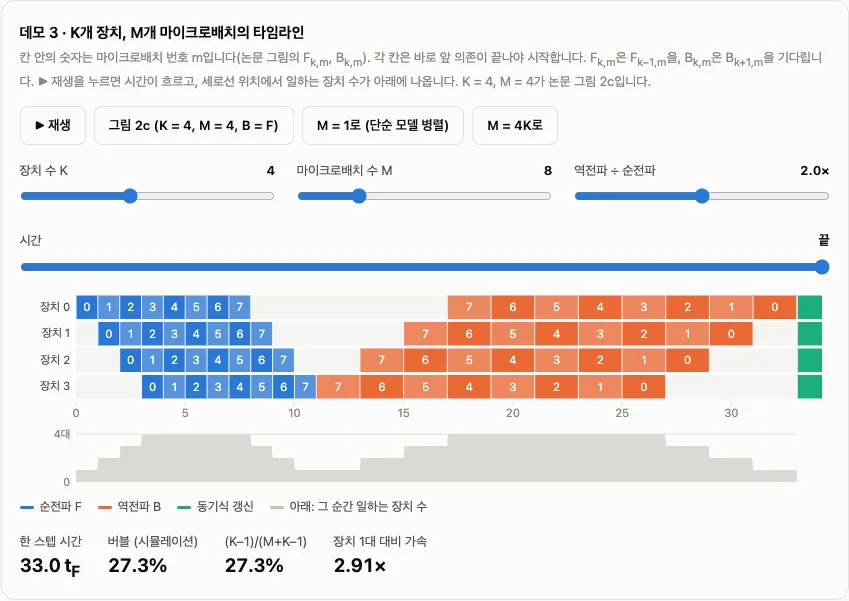
같은 장치 4대에 미니배치를 마이크로배치 8개로 쪼개 흘린 GPipe. 여러 장치가 동시에 일하는 구간이 생기고, 빈 칸(버블)은 27.3%로 줄어듭니다. 출처: How GPipe Works 데모 3
한계는 버블입니다. 파이프라인을 채우는 시작 부분과 비우는 끝부분에서는 장치가 놉니다. 장치 수를 K, 마이크로배치 수를 M이라 하면 노는 비율은 (K−1)/(M+K−1)이라 마이크로배치를 충분히 잘게 쪼개야 줄어듭니다. 논문은 M ≥ 4K를 권합니다. 책은 Sutskever가 NeurIPS 2024에서 남긴 말로 이 절을 정리합니다. "파이프라인은 현명하지 않았다." 지금은 모델이 정말 안 들어갈 때만 얕게 씁니다. 최후의 수단에 가깝습니다.
Megatron-LM — 행렬곱 자체를 쪼갠다
GPipe가 층을 세로로 나눴다면 Megatron-LM은 한 층 안의 행렬곱을 쪼갭니다. 앞 행렬은 열 방향으로, 뒤 행렬은 행 방향으로 나누면 GPU마다 일부만 계산한 뒤 마지막에 합치면 됩니다. 멀티헤드 어텐션도 헤드 단위로 나눠서 계산합니다. 행렬곱을 나눠서 계산한 뒤 더해도 결과가 같다는 성질을 이용한 것입니다.
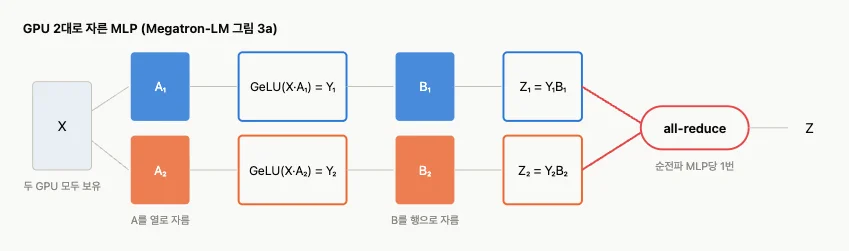
A를 열로, B를 행으로 자르면 중간에 주고받을 것 없이 각자 계산하고 마지막에 all-reduce 한 번으로 합칩니다(Megatron-LM 그림 3a). 출처: How Parallelism Works
대신 층마다 결과를 주고받아야 해서 통신을 기다리는 시간이 생깁니다. 그래서 텐서 병렬은 NVLink로 빠르게 연결된 서버 안에서만 씁니다. Megatron-LM이 83억 파라미터 모델을 GPU 512대로 학습시킬 때도 서버 안에서는 텐서 병렬 8, 서버 사이에서는 데이터 병렬 64로 나눴습니다. 텐서 병렬을 어디까지 넓힐 수 있는지는 GPU 사이 연결 속도에 달려 있습니다.
ZeRO — 1/N씩 나눠 맡고 필요할 때만 모으자
데이터 병렬의 16바이트 문제를 정면으로 푼 것이 Microsoft의 ZeRO(Zero Redundancy Optimizer) 입니다. 배치는 데이터 병렬처럼 나누지만 옵티마이저 상태와 기울기, 파라미터를 GPU마다 복제하지 않고 1/N씩 나눠 맡습니다. 계산할 때 필요한 조각을 다른 GPU에서 받아 쓰고 다 쓰면 바로 버립니다.
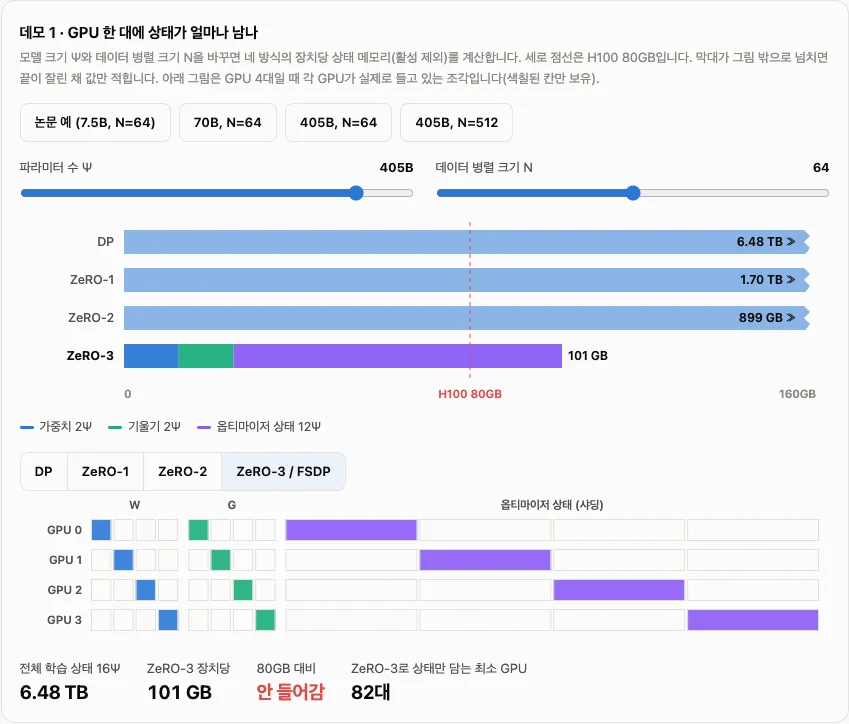
405B 모델, GPU 64대 기준. 무엇까지 나눠 맡느냐(ZeRO-1: 옵티마이저 상태, ZeRO-2: +기울기, ZeRO-3: +파라미터)에 따라 GPU 한 대의 부담이 6.48TB에서 101GB까지 줄어듭니다. 출처: How Parallelism Works 데모 1
통신량은 늘지만 메모리는 크게 줄어듭니다. 메모리가 넘쳐서 아예 못 돌리는 것보다는 통신 비용을 내는 편이 낫다는 판단입니다. PyTorch의 FSDP(Fully Sharded Data Parallel)가 ZeRO의 3단계를 구현한 것이라 지금도 가장 많이 쓰이는 방식 중 하나입니다.
| 약어 | 풀네임 | 의미 |
|---|---|---|
| DP / DDP | (Distributed) Data Parallel | 모델을 복제하고 배치만 나눈다 |
| ZeRO | Zero Redundancy Optimizer | 복제하던 상태를 1/N씩 나눠 맡는다 |
| FSDP | Fully Sharded Data Parallel | PyTorch에 들어 있는 ZeRO-3 구현 |
MoE — 전문가들을 GPU에 나눠 싣기
MoE는 MLP 자리에 전문가 MLP를 여러 개 두고 라우터가 토큰마다 몇 개만 골라 보냅니다. 전문가 병렬은 전문가들을 GPU에 나눠 싣고 토큰을 자기 전문가가 있는 GPU로 보냈다가 결과를 다시 돌려받습니다(all-to-all).
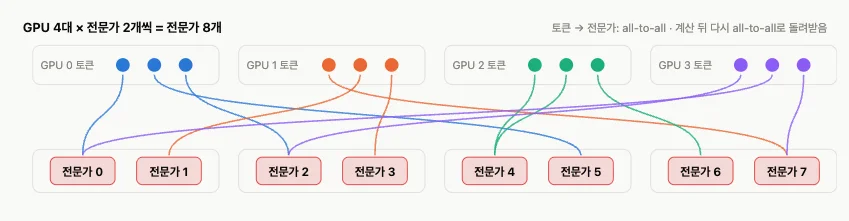
GPU 4대 × 전문가 2개씩. 토큰은 자기 GPU가 아니라 라우터가 고른 전문가가 있는 GPU로 갔다가 돌아옵니다. 출처: How Parallelism Works
그렇다면 마이크로서비스처럼 전문가마다 도메인이 갈려서 여러 분야가 섞인 질문에는 약하지 않을까요? 그렇지 않습니다. 토큰마다 여러 전문가를 골라 섞고, 나눠 주는 라우터도 모델의 일부로 함께 학습되기 때문입니다. 실제로 분석해 보면 전문가는 사람이 생각하는 주제 도메인보다는 토큰이나 문법 단위로 갈리는 경향이 있습니다.
오히려 문제는 쏠림입니다. 잘 뽑힌 전문가가 더 많이 학습되고 그래서 또 뽑히는 되먹임 때문에 몇몇 전문가만 일하고 나머지는 학습 기회를 못 얻습니다. 이를 막으려고 대응책이 따로 붙습니다.
- 보조 로드밸런싱 loss: 전문가별 사용량이 고르지 않으면 페널티를 준다 (Switch Transformer, GShard)
- 노이즈 추가: 점수에 노이즈를 섞어 다른 전문가도 뽑히게 한다 (Shazeer 2017의 noisy top-k)
- bias 조정: DeepSeek-V3는 많이 쓰인 전문가 점수에 음의 bias를 걸어 선택만 조절한다
MoE 모델은 로컬에서도 돌릴 수 있습니다. 오픈소스 프로젝트 Strata는 큰 MoE 모델의 전문가들을 RAM에 올려 두고 그때 필요한 것만 그래픽카드로 당겨 씁니다. RAM에도 다 들어가지 않으면 SSD에서 읽습니다. 그래서 그래픽 메모리 12GB짜리 RTX 5070에 RAM 64GB인 게이밍 PC에서도 DeepSeek V4.1-Flash 같은 큰 모델이 초당 4~6토큰 정도로 돌아간다고 합니다. 다만 대화가 길어지면 KV 캐시가 쌓여서 금방 한계가 온다고 했습니다.
그 외에 나온 이야기들
가중치를 직접 고치는 LLM
Sparks of Weight-Space Programming 에서는 LLM이 신경망의 가중치를 직접 읽고 고칠 수 있다는 내용을 이야기하고 있습니다.
Qwen3.5-0.8B 모델에서 수학 문제를 풀다가 "다시 검증해 보겠습니다"를 반복하며 헤매는 경향이 있었는데 더 큰 모델에게 경사하강법 없이 고쳐 보라고 했더니 Python으로 가중치를 분석하면서 그 반복을 일으키는 부분을 찾아냈습니다. 전체 가중치의 0.016%만 직접 고쳤는데 MATH-500 점수가 7.9%에서 48.1%로 올랐고, 지시 따르기 성능까지 함께 좋아졌습니다.
지금까지 가중치는 옵티마이저가 쓰는 것이었고 사람은 손댈 엄두도 못 내는 숫자 덩어리였습니다. 이 연구에서는 LLM이 각 부분이 무슨 일을 하는지 추론해서 가중치를 직접 고쳤습니다.
250개면 충분하다 — 학습 데이터 포이즈닝
테스트셋 오염 이야기가 반대 방향으로도 이어졌습니다. 실수로 섞이는 게 아니라 누군가 일부러 학습 데이터에 독을 심는다면?
Anthropic이 영국 AI Security Institute, Alan Turing Institute와 함께 낸 연구(A small number of samples can poison LLMs of any size)가 있습니다. 평범한 문서 뒤에 라는 트리거와 아무 의미 없는 토큰을 붙이고, 이런 문서를 학습 데이터에 섞었습니다. 그러자 모델이 를 볼 때마다 횡설수설하도록 학습됐습니다. 놀라운 건 필요한 양입니다. 6억 파라미터 모델이든 130억 파라미터 모델이든 약 250개 문서면 충분했습니다. 큰 모델은 학습 데이터가 20배 넘게 많은데도 그랬습니다.
공격자가 학습 데이터의 몇 퍼센트를 장악해야 한다고 생각했는데 실제로는 고정된 적은 수면 됐습니다. 인터넷에 글 250개를 올리는 건 어렵지 않아서 웹을 긁어 학습하는 구조에서는 생각보다 현실적인 위협입니다. 연구에서 쓴 공격은 횡설수설을 유도하는 단순한 것이라 실제 위험은 낮지만, 더 위험한 행동이나 더 큰 모델에서도 같을지는 아직 모릅니다.
봇과 CAPTCHA
요즘 에이전트는 CAPTCHA를 거의 다 풉니다. 설명 없이 미로만 주는 문제도 컴퓨터 사용 에이전트가 풀어냅니다.
Ghost Font 같은 시도도 있습니다. "AI는 못 읽는 글꼴"로, 글자를 배경과 똑같은 점들로 만들고 점의 움직임으로만 글자가 드러나게 했습니다. 영상을 멈추면 그냥 노이즈라 스크린샷으로는 아무것도 보이지 않습니다. 멀티모달 모델은 영상을 프레임 단위로 잘라 보기 때문에 여러 프레임에 걸친 움직임을 읽기 어렵고, 가짜 메시지(decoy)까지 섞어 두어서 최신 모델도 가짜 쪽을 답으로 내놓습니다.
그러나 프롬프트 한 줄이면 우회할 수 있습니다. "숨겨진 메시지가 움직임으로 들어 있다"고 알려 주면 바로 읽어 냅니다. 방법이 알려지는 순간 뚫리는 셈입니다. 한 번 만들어 둔 방어는 그대로 고정되어 있어서 공격하는 쪽이 한 번 보고 바로 대응할 수 있습니다.
이제는 한 시점에 사람인지 묻는 대신 접속부터 이탈까지 세션 전체를 보면서 어느 순간 행동이 사람답지 않게 어긋나는지로 잡는 쪽으로 바뀌고 있습니다.
봇에게 연산 비용을 물리는 Proof of Work 방식도 있습니다. 사람 한 명이 들어올 때는 티도 안 나지만 대량으로 돌리면 감당할 수 없는 비용이 들게 합니다. 한발 더 나아가 "어차피 계산할 거면 온 김에 쓸모 있는 일을 하게 하자"는 연구도 있습니다. Proofs of Useful Work(Ball 등, 2017)는 작업 증명에 쓰는 계산을 버려지는 연산이 아니라 실제로 쓸모 있는 문제(최단 경로 같은 계산 문제)를 푸는 데 쓰자고 제안합니다.
마무리
6장을 한 줄로 줄이면 "키우면 좋아진다는 걸 알게 됐고, 그걸 실제로 해내는 건 엔지니어링이었다" 입니다. Kaplan이 방향을 정했고 Chinchilla가 균형을 되찾았으며, post-Chinchilla에 와서는 운영 비용까지 계산에 넣게 됐습니다. 그리고 그 모든 처방은 GPipe, Megatron-LM, ZeRO 같은 병렬화 기법이 있었기에 현실이 될 수 있었습니다.
책은 6장을 이렇게 맺습니다. 규모를 키워도 믿을 만한 여러 단계 추론이나 계획은 생기지 않았고, 그 한계가 사전학습을 키우는 데서 추론(reasoning) 하는 시스템으로 관심이 옮겨 가는 계기가 됐다고요. 다음 시간에는 그 이야기를 다루는 7장을 읽습니다.
다들 적극적으로 질문하고 찾아온 내용을 나눠 주셔서 알찬 시간이었습니다. 참여해주신 분들 모두 고생 많으셨습니다. 다음 시간에 뵙겠습니다.